
Der Hype um künstliche Intelligenz hat eine neue Phase erreicht. Bisher kannte man Chatbots, die passiv auf eine Eingabe warten und dann antworten. Doch jetzt betreten autonome Agenten wie OpenClaw die Bühne. Diese Systeme warten nicht mehr, sondern sie agieren selbstständig. Man gibt ihnen ein grobes Ziel vor, und sie suchen eigenständig den Weg dorthin. Sie bedienen Browser, schreiben und korrigieren Code, verwalten Kalender und kommunizieren direkt mit anderen Software-Schnittstellen. Für Unternehmer und Entwickler bedeutet das einen radikalen Wandel im Arbeitsalltag. Statt Werkzeuge manuell zu bedienen, orchestriert man nun digitale Mitarbeiter. Das klingt verlockend, bringt aber völlig neue Herausforderungen mit sich, die in der ersten Euphorie oft übersehen werden.
Wer einen solchen digitalen Mitarbeiter rund um die Uhr beschäftigen möchte, wird schnell von der harten Realität der Betriebskosten eingeholt. Ein leistungsfähiger Agent, der ständig den Kontext prüft und komplexe Entscheidungen trifft, verbrennt Rechenleistung in einem atemberaubenden Tempo. Lässt man ein Spitzenmodell wie Claude Opus unbeaufsichtigt im Hintergrund laufen, können die Kosten an einem einzigen Tag astronomische Höhen erreichen.
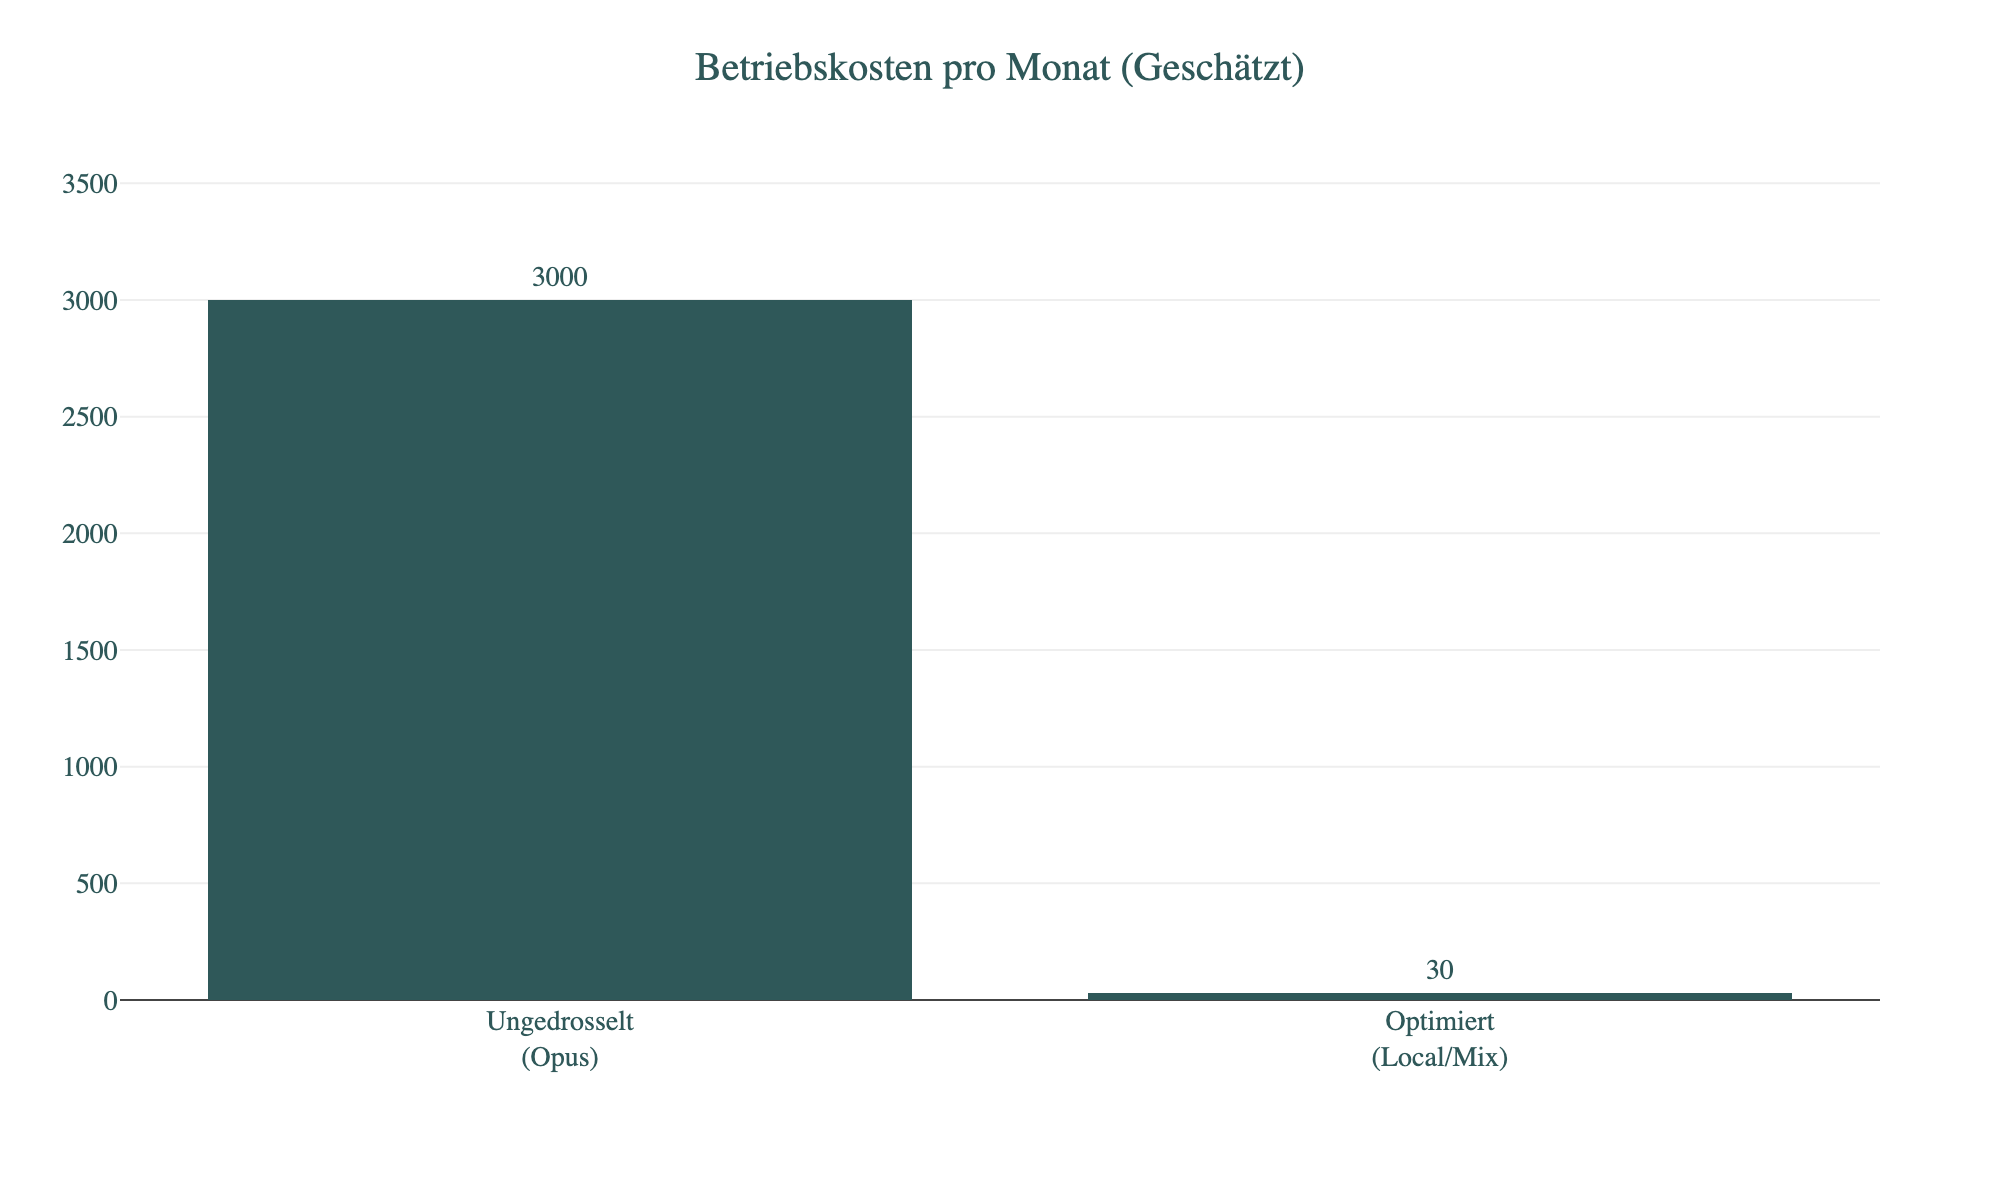
Es ist daher essenziell, nicht nur über die technische Machbarkeit, sondern vor allem über die Wirtschaftlichkeit nachzudenken. Man muss lernen, wie man die Intelligenz dosiert und teure Modelle nur dort einsetzt, wo sie wirklich nötig sind.
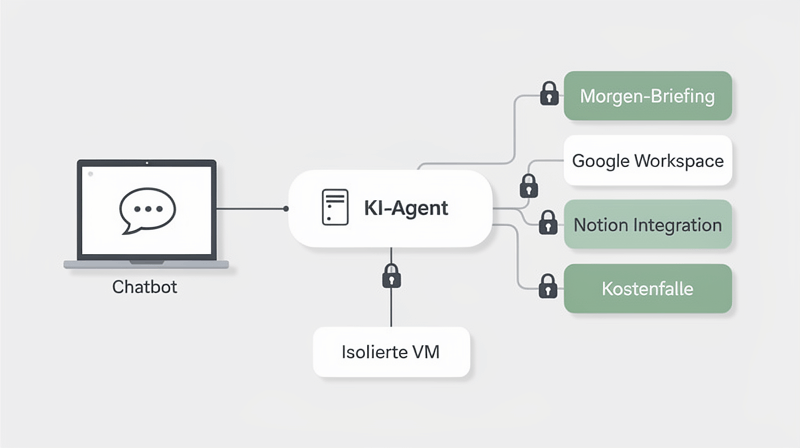
Abseits der Kosten stellt sich die Frage nach dem echten Nutzen im operativen Geschäft. Ein Agent, der nur das Wetter vorliest, ist bloße Spielerei. Echte Produktivität entsteht erst durch tiefgreifende Integrationen in die bestehende Firmenstruktur. Wenn der KI-Assistent Zugriff auf das Projektmanagement in Notion hat, E-Mails in Google Workspace vorrortiert und Marktrends auf Social Media eigenständig analysiert, wird aus der Software ein wertvoller Kollege. Man muss jedoch bereit sein, ihm die nötigen Rechte und Zugänge einzuräumen. Genau hier entsteht ein kritisches Spannungsfeld zwischen Effizienz und Datensicherheit. Wie viel Zugriff ist zu viel? Wo zieht man die Grenze zwischen hilfreicher Autonomie und einem unkalkulierbaren Sicherheitsrisiko für sensible Firmendaten?
Die erfolgreiche Implementierung eines solchen Systems erfordert weit mehr als nur einen Installationsbefehl im Terminal. Es verlangt eine klare Strategie für die Infrastruktur und die Datenhaltung. Man muss entscheiden, ob man auf bequeme Cloud-Dienste setzt oder die Hoheit über die Daten durch lokales Hosting auf eigener Hardware behält. Die Balance zwischen Performance, Kostenkontrolle und Sicherheit zu finden, ist die eigentliche Kunst beim Einsatz moderner KI-Agenten. Wer diese Hürde meistert, kann Arbeitsprozesse automatisieren, die bisher zwingend menschliche Intelligenz erforderten, und sich so einen massiven Wettbewerbsvorteil verschaffen.
Inhalt
Vom Chatbot zum digitalen Kollegen: Konkrete Anwendungsfälle
Ein KI-Agent wird erst dann zu einem echten Produktivitätsfaktor, wenn man aufhört, ihn wie ChatGPT zu behandeln. Wer OpenClaw oder ähnliche Systeme nur als besseres Textfeld nutzt, verschenkt 90% des Potenzials. Der eigentliche Wert entsteht durch Integration. Ein digitaler Kollege benötigt Zugriff auf Kalender, E-Mails und Projektmanagement-Tools, um nicht nur Fragen zu beantworten, sondern Aufgaben autonom zu erledigen.
Die Transformation vom passiven Chatbot zum aktiven Mitarbeiter erfordert ein Umdenken in der Struktur. Man muss bereit sein, Berechtigungen zu erteilen und Schnittstellen zu öffnen. Das mag zunächst Risiken bergen, doch mit der richtigen Isolierung, wie in späteren Kapiteln zur Sicherheit noch besprochen wird, entsteht ein System, das einem Unternehmer oder Projektleiter täglich mehrere Stunden Arbeit abnimmt.
Hier sind vier konkrete Szenarien, die zeigen, wie tief eine solche Autonomie statt Chatbot-Logik in den Arbeitsalltag eingreifen kann.
1. Das intelligente Morgen-Briefing: Mehr als nur Wetter und Nachrichten
Die meisten „Smarthome“-Briefings sind Spielerei. Wetterbericht, die Top-Schlagzeilen der Tagesschau und vielleicht ein Kalendereintrag. Für Unternehmer ist das nutzlos. Relevanz entsteht erst durch Kontext. Ein KI-Agent wie OpenClaw kann so konfiguriert werden, dass er wie ein menschlicher Assistent agiert, der schon zwei Stunden vor Arbeitsbeginn das Internet nach wirklich wichtigen Informationen durchforstet.
Der Prozess unterscheidet sich fundamental von einer Google-Suche. Der Agent kombiniert interne Unternehmensdaten mit externen Signalen.
Mach dein Business zukunftsfähig!
<mit smarter KI-Nutzung und cleverer Automatisierung nehmen wir dir Arbeit ab und schaffen Raum für das Wesentliche>
Lass dich kostenlos beraten
Der Workflow im Detail: 1. Interne Analyse: Der Agent loggt sich via API in das Projektmanagement-Tool (z.B. Notion oder ClickUp) ein. Er prüft: Welche Projekte sind im Verzug? Welches Thema hat heute Priorität? Angenommen, der Fokus liegt auf „KI-Integration in Unternehmen“. 2. Gezielte Externe Recherche: Mit diesem Kontextwissen nutzt der Agent Such-APIs (wie Brave Search oder Perplexity), um spezifisch nach Neuigkeiten zu diesem Fokus-Thema aus den letzten 24 Stunden zu suchen. Er ignoriert allgemeine Weltpolitik und sucht stattdessen nach neuen Papers, GitHub-Releases oder viralen Diskussionen auf X (ehemals Twitter) und Reddit. 3. Synthese und Aufbereitung: Statt einer Linkliste erstellt der Agent ein kuratiertes Dokument. Er fasst zusammen: „Es gibt eine neue Open-Source-Bibliothek, die unser Problem bei Projekt X lösen könnte (Link zu GitHub). Außerdem diskutiert die Konkurrenz gerade über Regulierung Y.“
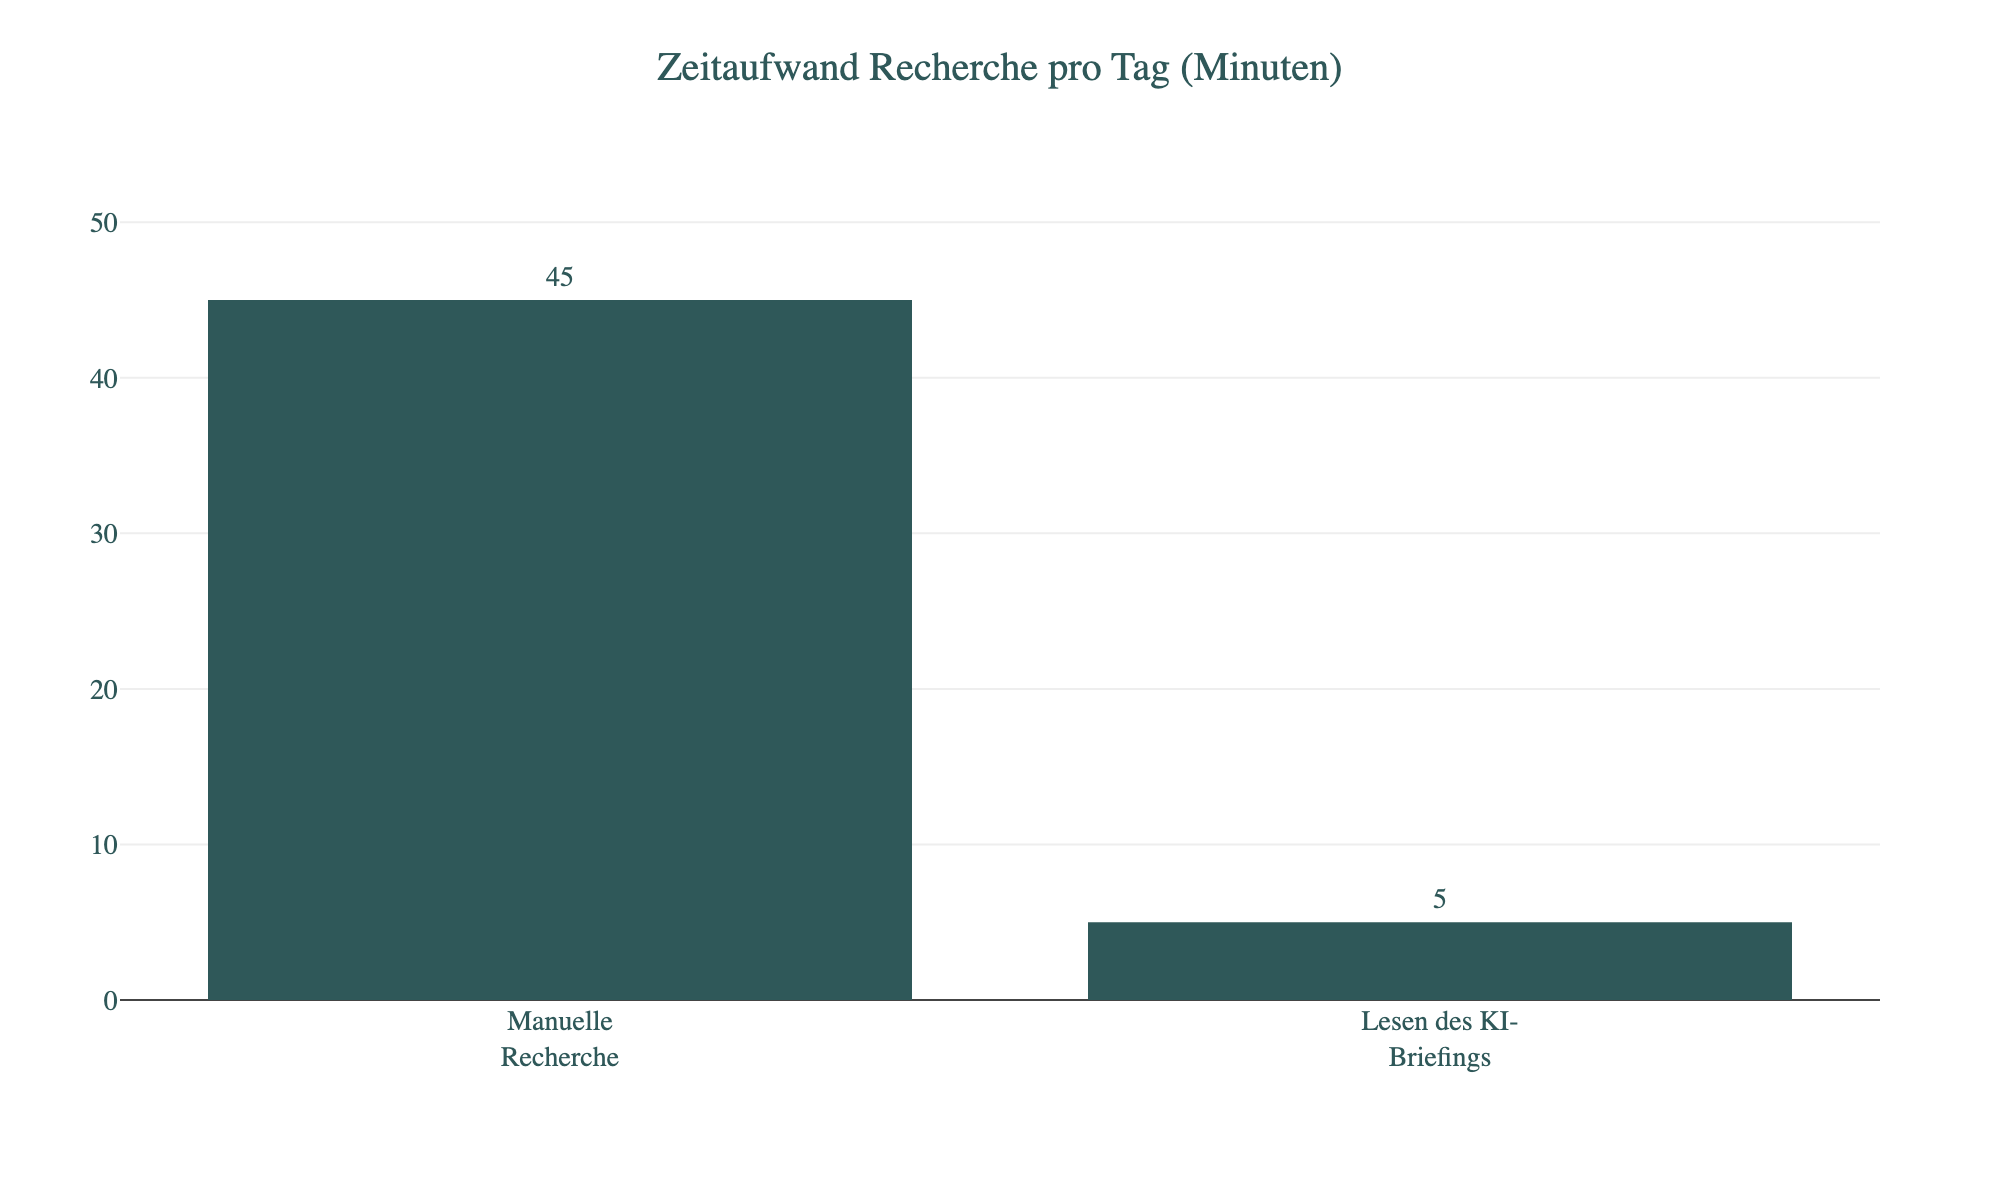
Der Zeitgewinn ist massiv, aber der wahre Vorteil ist die Filterung. Man konsumiert keine algorithmisch optimierten Newsfeeds mehr, die auf Ablenkung ausgelegt sind, sondern erhält eine strategische Übersicht.
2. Echte Integration in Google Workspace: Der „Digitale Mitarbeiter“
Der wohl mächtigste Hebel für die Produktivität ist die Behandlung der KI als vollwertigen Mitarbeiter innerhalb der Google Workspace Umgebung (oder Microsoft 365). Viele Nutzer machen den Fehler, ihren eigenen Haupt-Account mit der KI zu verknüpfen. Das ist aus Sicherheitsgründen riskant und organisatorisch unsauber.
Besser ist der Ansatz des „Digitalen Zwillings“ oder des dedizierten Assistenten-Accounts. Man legt für den Agenten einen eigenen Google-Workspace-User an (z.B. „“). Das kostet zwar eine Lizenzgebühr mehr, schafft aber klare Verhältnisse.
Szenario Kalender-Management: Die Terminfindung ist oft ein Zeitfresser. Mit einem integrierten Agenten ändert sich der Ablauf radikal. Man teilt den eigenen Kalender mit dem User des Agenten (Lesezugriff oder „Änderungen vornehmen“). Wenn man nun im Chat oder per Sprachnachricht sagt: „Blocke mir morgen Nachmittag zwei Stunden für Deep Work und verschiebe das Meeting mit Herrn Müller auf Donnerstag“, greift der Agent direkt auf die API zu. * Er prüft die Verfügbarkeit im Hauptkalender. * Er sendet vom eigenen Account eine Einladung an den Nutzer und ggf. an Herrn Müller. * Er trägt den Blocker ein.
Für den Nutzer taucht der Termin einfach auf. Man muss nur noch „Annehmen“ klicken. Das Gefühl ist nicht das Bedienen einer Software, sondern die Interaktion mit einem Sekretariat.
Szenario Dokumenten-Erstellung: Ähnlich verhält es sich mit Google Drive. Man sollte dem Agenten keinen Vollzugriff auf das gesamte Firmen-Drive geben. Stattdessen erstellt man einen geteilten Ordner „Inbox & Entwürfe“. Wenn der Befehl lautet: „Erstelle einen Entwurf für das Angebot an Kunde Meier basierend auf unseren Notizen“, generiert der Agent das Google Doc nicht im Chat als Textblock, sondern erstellt physisch eine Datei im Ordner. Er nutzt Formatierungen, Überschriften und Kommentare. Der Link zum Dokument wird im Chat bereitgestellt. Man öffnet es und arbeitet direkt im finalen Medium weiter.
3. Proaktives Projektmanagement in Notion
Die meisten Chatbots sind reaktiv. Sie warten auf Input. Ein echter Agent, der über eine „Heartbeat“-Funktion verfügt (also regelmäßig im Hintergrund aufwacht), kann proaktiv managen. Dies ist besonders wertvoll in Verbindung mit Datenbanken wie Notion. Hier zeigt sich der Wert von individueller Softwareentwicklung und Skripting, da man Standard-Schnittstellen oft erweitern muss.
In der Praxis bedeutet das: Der Agent scannt alle 30 oder 60 Minuten das Notion-Board. Er sucht nach Mustern, nicht nur nach Stichworten.
Beispielhafte autonome Aktionen: * Status-Updates: Der Agent erkennt, dass ein Ticket „Recherche API“ seit 3 Tagen im Status „In Arbeit“ ist. Er prüft, ob er selbst dazu Daten geliefert hat. Wenn ja, fragt er im Chat proaktiv: „Ich habe dir die API-Daten schon vorgestern geliefert. Soll ich das Ticket auf ‚Erledigt‘ setzen?“ * Deadline-Wächter: Erkennt der Agent, dass eine Deadline in 24 Stunden abläuft, der Status aber noch „Offen“ ist, schlägt er Alarm. Nicht als nervige Notification, sondern mit einem Lösungsvorschlag: „Die Deadline für X ist morgen. Fehlen dir Infos? Ich könnte schon mal einen ersten Entwurf basierend auf den Meeting-Notizen vorbereiten.“ * Datenpflege: Oft vergessen Teams, Tickets sauber zu taggen. Der Agent kann nachts durchlaufen und fehlende Tags basierend auf dem Inhalt der Karte ergänzen oder Tickets den richtigen Personen zuweisen.
Dieser Ansatz verwandelt das Projektmanagement-Tool von einem statischen Friedhof für Aufgaben in ein lebendiges System. Der Agent agiert hier als „Gärtner“, der das Unkraut (Veraltetes) entfernt und die Pflanzen (Projekte) pflegt.
4. Das automatisierte Gedanken-Tagebuch für unterwegs
Unternehmer und Kreative haben ihre besten Ideen oft nicht am Schreibtisch, sondern im Auto oder beim Spaziergang. Sprachmemos sind schnell aufgenommen, aber schwer auszuwerten. Wer hört sich schon gerne zehn Minuten eigene Sprachnachrichten an, um eine Information zu finden?
Hier wird OpenClaw zum perfekten Sekretär. Durch die Anbindung an Messenger wie Telegram oder WhatsApp in Kombination mit der Whisper-Technologie (Spracherkennung) entsteht ein nahtloser Workflow.
Der Prozess „Voice-to-Knowledge“: 1. Input: Man spricht eine unstrukturierte Notiz in das Handy. „Mir ist gerade eingefallen, für das Projekt Müller müssen wir unbedingt noch die SEO-Optimierung prüfen, da gab es dieses neue Google Update. Und erinner mich daran, morgen Milch zu kaufen.“ 2. Transkription & Split: Der Agent wandelt Audio in Text um. Er erkennt, dass es sich um zwei völlig verschiedene Informationen handelt. 3. Routing & Aktion: * Information A (Projekt Müller/SEO): Der Agent öffnet das entsprechende Projekt in Notion oder erstellt ein Dokument im Drive-Ordner. Er formuliert die Idee aus und speichert sie als strukturierte Aufgabe: „To-Do: SEO-Audit für Müller bzgl. neuem Core-Update prüfen.“ * Information B (Milch): Der Agent erkennt den privaten Charakter und setzt es auf die einfache Einkaufsliste oder in die Apple Reminders (sofern angebunden).
Am Ende des Tages erhält man kein Audio-File, sondern fertig einsortierte Aufgaben. Das mentale Rauschen wird sofort in strukturierte Aktionen verwandelt. Es geht nichts verloren.
Warum diese Integrationen den Unterschied machen
Der Einsatz dieser vier Szenarien erfordert initiale Einrichtungszeit. Man muss API-Keys generieren, Webhooks einrichten und Berechtigungen verwalten. Doch der Aufwand lohnt sich. Ein Chatbot, mit dem man nur chattet, ist ein Spielzeug. Ein Agent, der Zugriff auf die Werkzeuge der Arbeit hat, ist ein Multiplikator für die eigene Leistung.
Dabei ist jedoch Vorsicht geboten. Je mehr Zugriff ein System hat, desto höher ist das Risiko bei Fehlfunktionen oder Sicherheitslücken. Wenn ein Agent E-Mails schreiben darf, kann er auch falsche E-Mails schreiben. Deshalb ist die Wahl der richtigen Modelle und die Überwachung der Kosten entscheidend, Themen, die wir in den nächsten Abschnitten im Detail betrachten werden, um böse Überraschungen auf der Kreditkartenabrechnung zu vermeiden.
Die Kostenfalle verstehen: Warum ‚Heartbeats‘ teuer sind
Das finanzielle Erwachen kommt bei autonomen KI-Agenten meist nach den ersten 24 Stunden. Wer OpenClaw oder ähnliche Frameworks mit der Standardkonfiguration startet und einfach laufen lässt, sieht sich am nächsten Tag oft mit API-Rechnungen konfrontiert, die das Budget eines ganzen Monats sprengen. Der Grund dafür liegt nicht in der Menge des Textes, den die KI schreibt, sondern in der Art und Weise, wie sie „denkt“ und ihre Umgebung überwacht.
Um diese Kostenfalle zu entschärfen, muss man verstehen, dass ein Agent kein Chatbot ist. Ein Chatbot reagiert nur, wenn man ihn anspricht. Ein Agent hingegen agiert proaktiv. Dieser kleine Unterschied ändert die Kostenstruktur fundamental.
Input-Tokens: Der unsichtbare Preistreiber
Das größte Missverständnis bei der Nutzung von Large Language Models (LLMs) via API ist die Annahme, man bezahle primär für das Ergebnis. Tatsächlich machen die Input-Tokens, also das, was die KI lesen und verarbeiten muss, bevor sie auch nur ein Wort schreibt, den Löwenanteil der Kosten aus.
Moderne LLMs sind „stateless“. Das bedeutet, sie haben kein Gedächtnis. Wenn man OpenClaw eine Aufgabe gibt, weiß das Modell im nächsten Schritt nicht mehr, was gerade passiert ist, es sei denn, man schickt ihm den gesamten Verlauf erneut.
Ein autonomer Agent schleppt also permanent einen gewaltigen Rucksack an Informationen mit sich herum: 1. System-Prompt: Die grundlegende Programmierung (Wer bist du? Was darfst du?). 2. Chat-Verlauf: Was wurde bisher besprochen? 3. Dateien & Kontext: Der Inhalt aller Dateien, die gerade im Fokus sind (z.B. Code-Snippets, E-Mails, Dokumentationen). 4. Tool-Definitionen: Die Anleitung, wie er Werkzeuge wie Google Calendar oder Notion benutzt.
Bei jedem einzelnen Aufruf („Request“) werden diese Daten an die API gesendet und berechnet. Wenn der Kontext beispielsweise 20.000 Tokens umfasst (was bei Code-Analysen wenig ist), kostet allein das „Hallo sagen“ bei einem High-End-Modell wie Claude Opus 4.6 bereits echtes Geld, und zwar jedes Mal.
Das Problem mit dem „Heartbeat“ (30-Minuten-Takt)
Hier wird es kritisch. Damit OpenClaw autonom agieren kann, etwa um zu prüfen, ob neue E-Mails eingegangen sind oder ob sich ein Status in Notion geändert hat -, muss das System regelmäßig „aufwachen“. Dies nennt man den „Heartbeat“ oder die „Loop“.
In der Standardeinstellung prüft der Agent oft alle 15 bis 30 Minuten die Lage. Der Prozess sieht technisch so aus: 1. Der Timer läuft ab. 2. Das System sammelt den gesamten Kontext (Verlauf + Tools). 3. Es sendet diesen Riese-Datenblock an die KI mit der Frage: „Gibt es basierend auf diesem Kontext und den aktuellen Daten etwas zu tun?“ 4. Die KI analysiert alles und antwortet meistens: „Nein, alles ruhig.“
Bereit, Dein Projekt auf das nächste Level zu bringen?
<Wir sind dein Partner für maßgeschneiderte und individuelle Lösungen. Lass uns gemeinsam deine Vision umsetzen>
Jetzt unverbindlich beraten lassenDas Problem: Auch für dieses „Nein“ hat die KI den gesamten Kontext von vielleicht 50.000 Tokens lesen müssen.
Eine einfache Rechnung verdeutlicht das Desaster bei High-End-Modellen: Nehmen wir an, der Kontext ist gut gefüllt (ca. 100.000 Tokens, was bei komplexen Projekten schnell erreicht ist). Der Preis für Input bei Claude 3 Opus liegt bei etwa 15,00 $ pro 1 Million Tokens.
- Ein einziger Check („Heartbeat“): 100.000 Tokens = 1,50 $.
- Frequenz: Alle 30 Minuten = 48 Checks pro Tag.
- Kosten pro Tag nur für den Leerlauf: 48 * 1,50 $ = 72,00 $.
Man zahlt also über 2.000 $ im Monat, nur damit der Agent existiert und prüft, ob er arbeiten soll. Das ist wirtschaftlich für die meisten KMU nicht tragbar. Hier zeigt sich, dass Autonomie statt Chatbot nicht nur Vorteile, sondern auch finanzielle Risiken birgt.
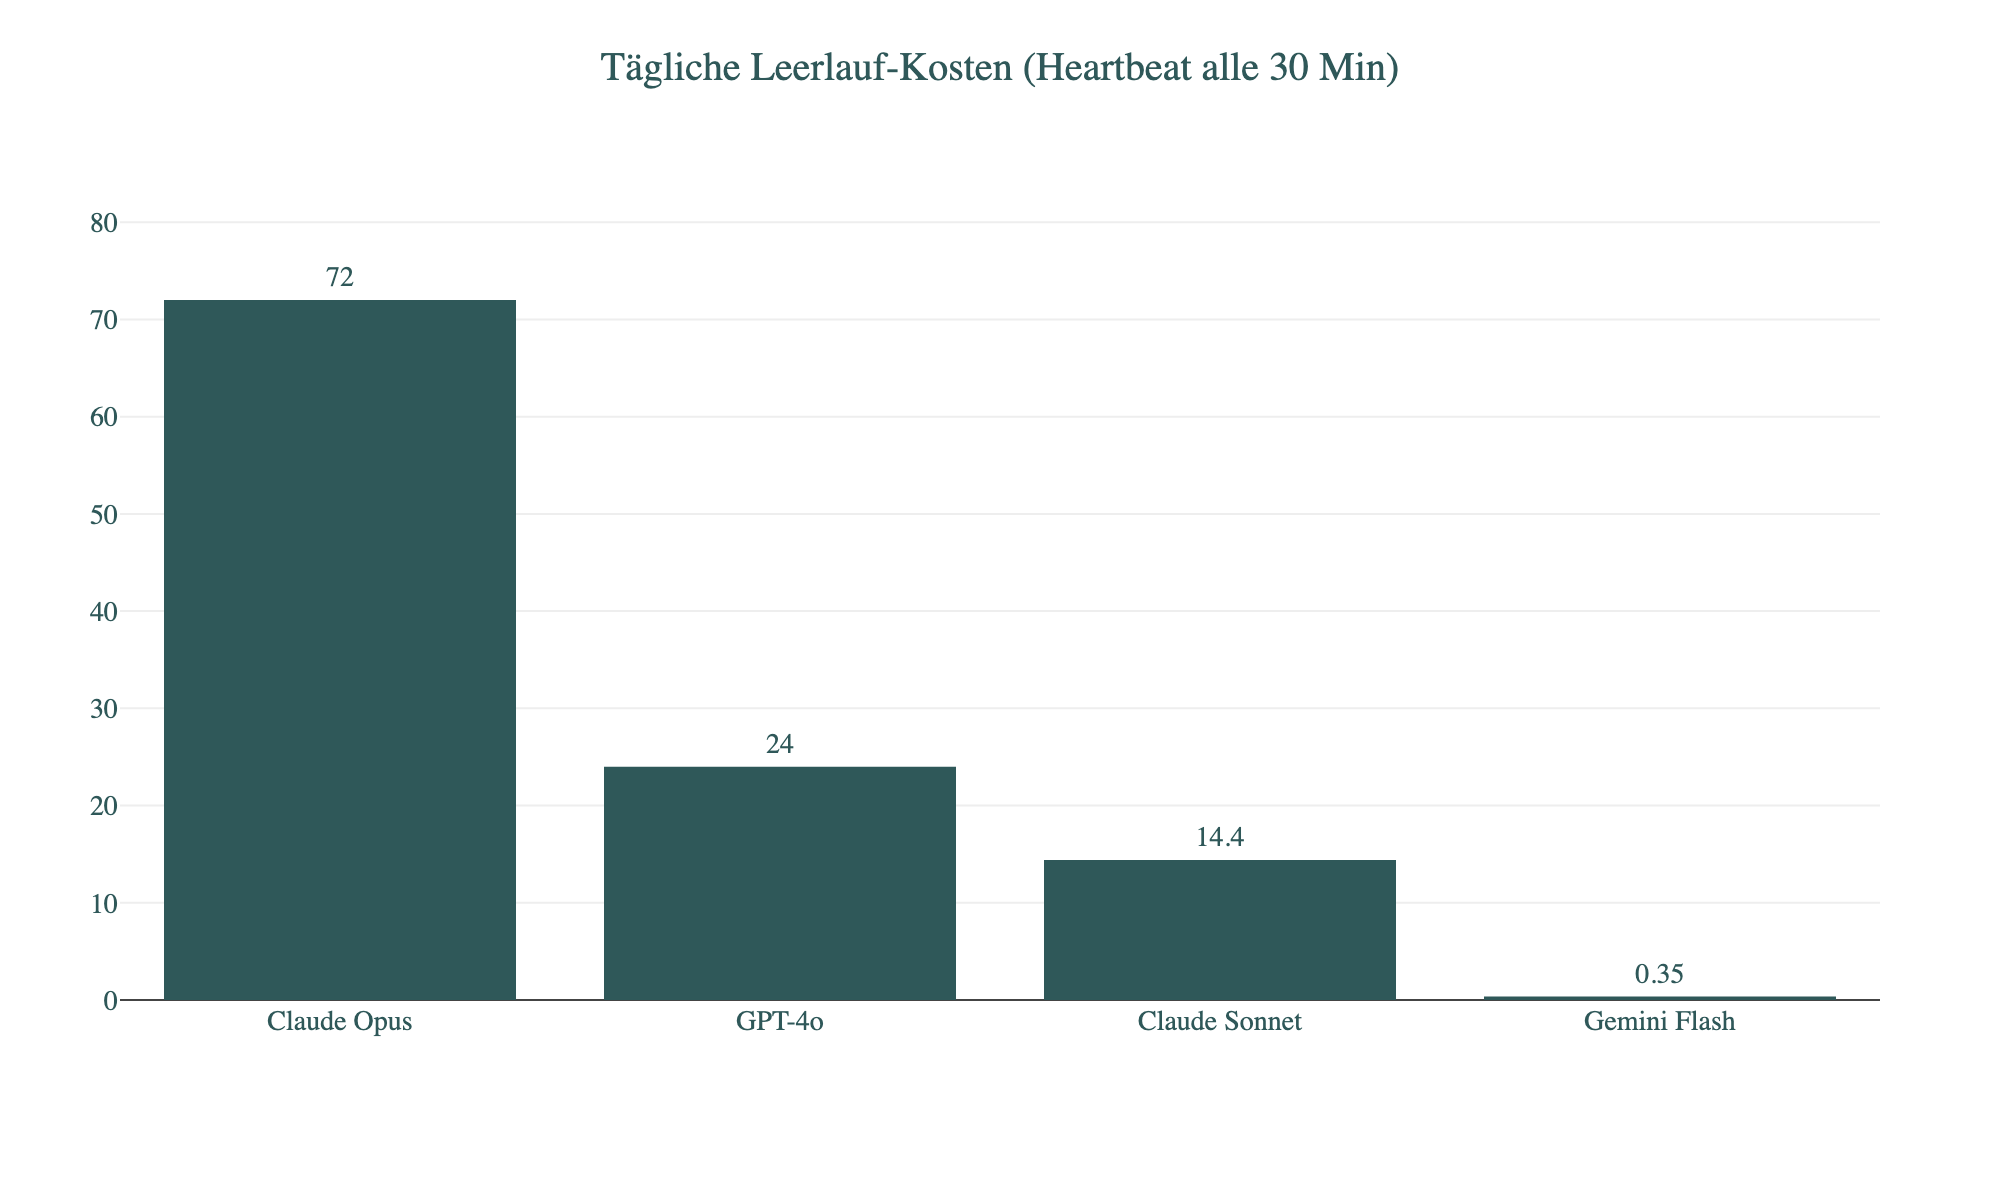
Kostenvergleich: Claude Opus vs. Gemini Flash
Die Lösung für das Heartbeat-Problem liegt nicht im Abschalten der Autonomie, sondern in der Wahl des richtigen „Wachhundes“. Man stellt keinen promovierten Astrophysiker ein, um alle 30 Minuten in den Briefkasten zu schauen. Genau das tut man aber, wenn man Claude Opus für den Heartbeat nutzt.
Für die reine Überwachung und einfache Routineaufgaben benötigt man Modelle, die zwei Kriterien erfüllen: 1. Extrem günstiger Input: Da wir ständig riesige Mengen Kontext senden. 2. Großes Kontext-Fenster: Damit nichts abgeschnitten wird.
Hier kommt Google Gemini 1.5 Flash (oder vergleichbare Modelle wie Haiku oder Kimi) ins Spiel. Gemini Flash wurde spezifisch für massiven Kontext bei minimalen Kosten entwickelt.
Ein direkter Vergleich der Input-Kosten (Stand marktüblicher API-Preise):
| Merkmal | Claude 3 Opus | Claude 3.5 Sonnet | Gemini 1.5 Flash |
|---|---|---|---|
| Input-Preis (pro 1M Token) | ~$15,00 | ~$3,00 | ~$0,075 |
| Kosten für 1 Heartbeat (100k) | $1,50 | $0,30 | $0,0075 |
| Kosten pro Tag (48 Checks) | $72,00 | $14,40 | $0,36 |
Der Unterschied ist gigantisch. Durch den Wechsel des Modells für den Loop-Prozess sinken die Kosten von einem Monatsgehalt auf das Niveau einer Tasse Kaffee. Dabei ist die „Intelligenz“ von Gemini Flash vollkommen ausreichend, um zu entscheiden: „Da ist eine neue E-Mail, ich sollte den ‚Email-Bearbeitungs-Agenten‘ wecken.“
Wann sich der Einsatz von High-End-Modellen lohnt
Bedeutet das, man sollte Claude Opus oder GPT-4o gar nicht mehr nutzen? Keineswegs. Man muss sie nur gezielt einsetzen. Dies ist ein Kernelement jeder strategischen KI Integration in Unternehmen.
Das Zauberwort heißt „Model Routing“ oder „Tiered Execution“. Man konfiguriert OpenClaw so, dass standardmäßig das günstige Modell läuft (Level 1). Erst wenn eine Aufgabe komplex wird, darf der Agent „hochskalieren“.
Szenarien für High-End-Modelle (Level 2):
- Komplexes Coding: Wenn der Agent nicht nur einen Einzeiler ändern, sondern eine neue Funktion in eine bestehende Software-Architektur integrieren soll. Hier spart die höhere Intelligenz von Opus Folgekosten, weil es seltener Fehler macht, die korrigiert werden müssen.
- Kreative Textarbeit: Wenn der Agent einen Blogpost oder eine Kundenantwort verfassen soll, die empathisch und stilistisch brillant sein muss. Günstige Modelle klingen oft roboterhaft.
- Tiefenanalyse: Wenn unstrukturierte Daten aus PDF-Dokumenten extrahiert und logisch verknüpft werden müssen, scheitern kleine Modelle oft an den Nuancen.
Der ideale Workflow sieht also so aus: * Heartbeat (Alle 30 Min): Gemini Flash prüft Status. Kosten: fast null. * Erkennung: Flash findet eine Aufgabe: „Schreibe ein Python-Skript für die Datenanalyse“. * Delegation: Flash gibt die Aufgabe an Claude Sonnet oder Opus weiter. * Ausführung: Opus löst die Aufgabe (teuer, aber einmalig). * Rückkehr: Das System fällt zurück in den Schlafmodus mit Flash.
So kombiniert man die 24/7-Verfügbarkeit mit der Spitzenleistung der Top-Modelle, ohne Geld zu verbrennen.
Token-Verschwendung durch „Looping Errors“
Ein weiterer Kostenfaktor, der oft übersehen wird, sind Fehler-Schleifen. Agenten versuchen autonom, Probleme zu lösen. Wenn ein günstiges Modell (oder auch ein teures) einen Fehler macht, etwa einen falschen Terminal-Befehl ausführt -, erhält es eine Fehlermeldung.
Ein schlecht konfigurierter Agent versucht es dann erneut. Und erneut. Und erneut. Jeder Versuch kostet Input- und Output-Tokens. Wenn man morgens aufwacht und sieht, dass der Agent 500 Mal versucht hat, eine Datei zu öffnen, die nicht existiert, ist das Geld weg.
Um dies zu verhindern, setzt man Limits: 1. Maximale Iterationen: Der Agent darf maximal 5 Versuche unternehmen, um ein Teilproblem zu lösen. Danach muss er abbrechen und den Menschen benachrichtigen. 2. Budget-Limits: Viele API-Provider (OpenRouter, Anthropic) erlauben das Setzen von harten Kostenlimits (z.B. „Maximal 10 $ pro Tag“). Ist das Limit erreicht, stoppt der Agent. Das ist die Notbremse, die jeder eingerichtet haben sollte.
Zusammenfassend lässt sich sagen: Die Kosten eines KI-Agenten korrelieren nicht primär mit der Arbeitslast, sondern mit der Konfiguration des Leerlaufs und des Kontext-Managements. Wer das versteht, kann mächtige Automatisierung für wenige Cent am Tag betreiben. Wer es ignoriert, zahlt Lehrgeld.
Das Low-Cost-Setup: Kimi k2.5, Ollama und VPS
Wer einen autonomen KI-Agenten wie OpenClaw produktiv nutzen möchte, stößt fast augenblicklich auf eine harte technische Grenze: die Hardware. Ein klassischer Virtual Private Server (VPS), wie man ihn für Webhosting oder einfache Datenbanken mietet, verfügt zwar über CPU-Kerne und RAM, aber in den seltensten Fällen über die notwendige GPU-Leistung (VRAM).
Genau hier liegt das Missverständnis vieler Einsteiger. Ein Sprachmodell (LLM) wie Kimi k2.5 oder Llama 3 benötigt für die Inferenz, also den Prozess des „Denkens“ und Antwortens, massiven parallelen Rechenaufwand. Versucht man, ein solches Modell rein über die CPU eines Standard-VPS laufen zu lassen, wartet man Minuten auf ein einziges Wort. Das System wird unbenutzbar.
Die Lösung für ein kosteneffizientes Setup liegt daher nicht darin, teure GPU-Server für hunderte Euro im Monat zu mieten, sondern in der Entkopplung: Der Agent (die Logik von OpenClaw) läuft auf einem günstigen VPS, das „Gehirn“ (das Modell) wird extern via API oder Cloud-Dienst angebunden. Hierarchisch betrachtet übernimmt der VPS nur die Verwaltung der Aufgaben und den „Heartbeat“, während die schwere Rechenlast ausgelagert wird.
Die Hardware-Lüge: Warum lokales Hosting oft scheitert
Der Begriff „lokal hosten“ wird oft missverstanden. Man kann OpenClaw problemlos auf einem eigenen Laptop installieren. Doch sobald der Laptop in den Ruhezustand geht oder man ihn zuklappt, stirbt der Agent. Ein 24/7-Assistent benötigt eine Umgebung, die niemals schläft.
Ein Heimserver (z.B. ein alter PC im Keller) wäre eine Option, treibt aber die Stromkosten in die Höhe und erfordert eine stabile statische IP oder Tunnel-Lösungen wie Cloudflare Tunnels, um sicher mit der Außenwelt (z.B. Webhooks von GitHub oder Google) zu kommunizieren.
Deshalb ist ein VPS (Virtual Private Server) bei Anbietern wie Hetzner oder Hostinger der Goldstandard für die Logik-Ebene. Für ca. 5 bis 10 Euro im Monat erhält man eine stabile Docker-Umgebung. Die Herausforderung bleibt jedoch das Modell selbst. Da der VPS keine Grafikkarte hat, müssen wir das Modell Kimi k2.5 über externe Schnittstellen „hereinholen“.
Weg 1: Die kostenlose Route via NVIDIA API
NVIDIA bietet derzeit eine der spannendsten Möglichkeiten für Entwickler, Hochleistungsmodelle fast ohne Kosten zu nutzen. Über die NVIDIA NIM (NVIDIA Inference Microservices) stellt der Chip-Gigant diverse Modelle, darunter auch das leistungsstarke Kimi k2.5, als API zur Verfügung.
Das Ziel von NVIDIA ist hierbei nicht primär der Verkauf von API-Credits, sondern die Demonstration der eigenen Hardware-Dominanz. Man kann dies als „Marketing-Subvention“ betrachten.
Die Vorteile liegen auf der Hand: * Kosten: Aktuell bietet NVIDIA großzügige Free-Tier-Kontingente für Entwickler. Für den privaten oder kleingewerblichen Betrieb eines einzelnen Agenten zahlt man oft 0 Euro. * Performance: Die Modelle laufen auf Enterprise-Hardware (H100 Cluster), was extrem schnelle Antwortzeiten garantiert. * Kimi k2.5: Dieses Modell hat sich als Geheimtipp etabliert. Es besitzt ein riesiges Kontext-Fenster (es kann sich also viel merken) und agiert in der Logik sehr ähnlich zu den teuren Modellen von OpenAI oder Anthropic.
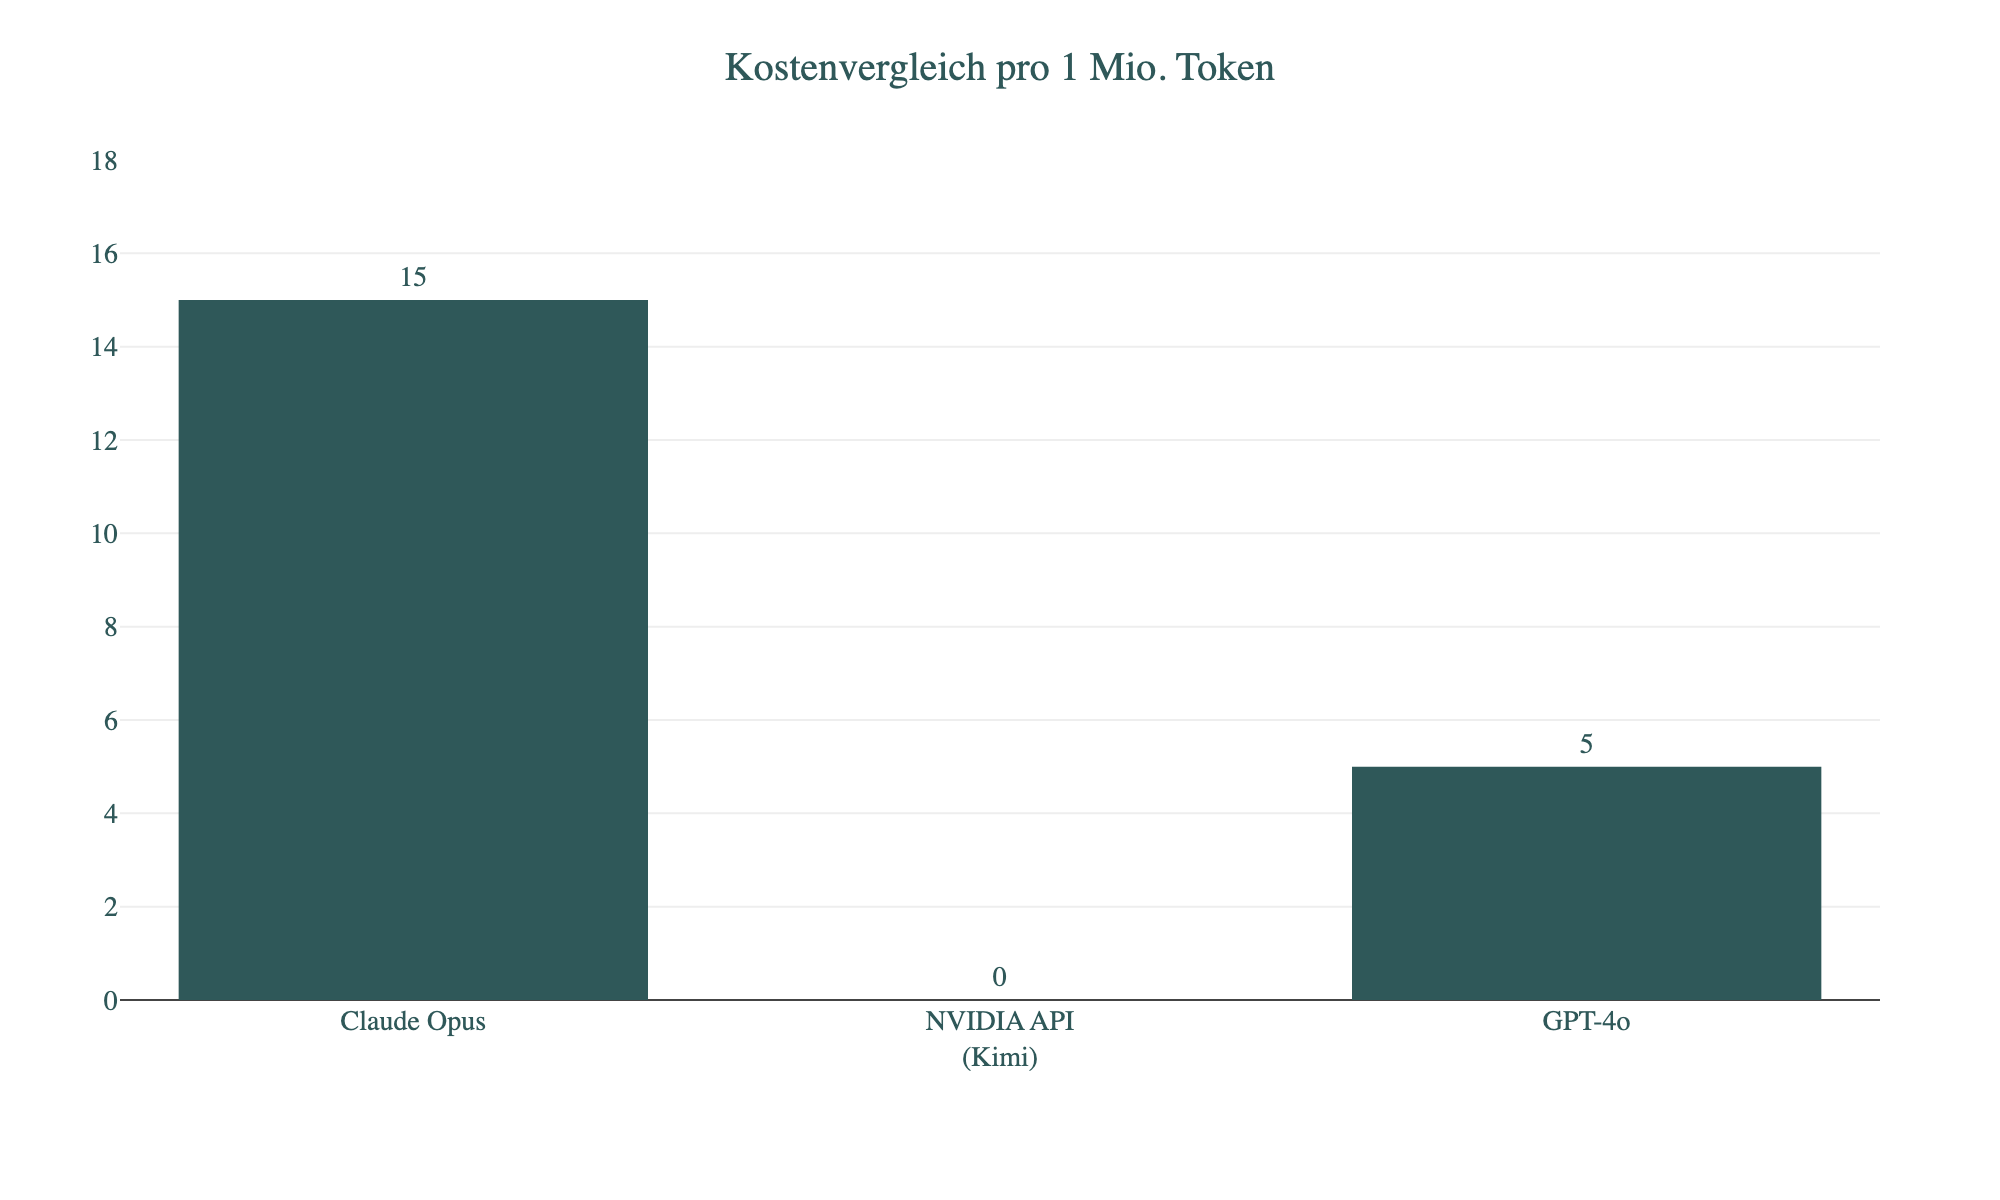
Die Einrichtung erfolgt simpel: Man erstellt einen Account im NVIDIA Developer Portal, generiert einen API-Key (beginnt meist mit nvapi-) und trägt diesen in die OpenClaw-Konfiguration ein. Es ist keine lokale Installation des Modells nötig; der VPS sendet lediglich den Text an NVIDIA und erhält die Antwort zurück.
Weg 2: Die stabile Route via Ollama Cloud
Wer sich nicht auf Test-APIs verlassen möchte, die jederzeit gedrosselt werden könnten, wählt den Weg über Ollama. Ollama ist der De-facto-Standard für den Betrieb von Open-Source-Modellen. Normalerweise läuft Ollama lokal auf dem Rechner. Da unser VPS aber keine GPU hat, nutzen wir Ollama in Verbindung mit einem Cloud-Provider oder einem Remote-Service.
Einige Anbieter ermöglichen es, Ollama-Endpunkte als „Service“ zu buchen. Man zahlt hier oft eine Pauschale (z.B. ca. 20 Euro im Monat) und kann dafür diverse Modelle nutzen, ohne pro Token abgerechnet zu werden. Das ist ideal für Agenten mit einem aktiven „Heartbeat“, die alle paar Minuten den Status prüfen. Bei einem Token-basierten Preismodell würde dieser ständige „Puls“ Geld kosten; bei einer Flatrate spielt es keine Rolle, wie oft der Agent „aufwacht“.
Man installiert also Ollama als Docker-Container auf dem VPS, konfiguriert diesen aber so, dass er die Rechenlast nicht auf der (schwachen) VPS-CPU ausführt, sondern an den gebuchten Cloud-Endpunkt weiterleitet. Dies erfordert Eingriffe in die Docker-Konfiguration, ist aber die robusteste Lösung für den Dauereinsatz. Wer Unterstützung bei solch einer komplexen Individuellen Softwareentwicklung benötigt, sollte sich vorab genau mit Docker-Netzwerken befassen.
Technische Hürde: Docker-Bridge und Port-Mapping
Die größte Stolperfalle bei der Einrichtung auf einem VPS ist die Kommunikation zwischen den Containern. OpenClaw läuft in einem Docker-Container. Ollama (oder der Proxy dazu) läuft oft in einem anderen Container oder bindet einen Port auf dem Host-System.
Ein häufiger Fehler: Man trägt in der Konfiguration localhost oder 127.0.0.1 ein.
Das Problem: Innerhalb des OpenClaw-Containers bedeutet localhost „ich selbst“ (also der OpenClaw-Container). Der Ollama-Dienst ist dort aber nicht zu finden.
Die Lösung: Die Docker Bridge IP
Docker erstellt standardmäßig ein virtuelles Netzwerk zwischen den Containern. Die Gateway-IP dieses Netzwerks ist meistens 172.17.0.1.
Um OpenClaw mit Ollama zu verbinden, muss man in der config.json von OpenClaw folgende Adresse als Basis-URL (Base URL) für das Modell angeben:
http://172.17.0.1:[PORT]/v1
Der [PORT] ist hierbei entscheidend. Es ist jener Port, den man beim Start des Ollama-Containers nach außen freigegeben hat (Mapping). Standardmäßig nutzt Ollama Port 11434. Wenn man diesen Port im Docker-Befehl mit -p 11434:11434 gemappt hat, lautet die Adresse: http://172.17.0.1:11434/v1.
docker ps aus. In der Spalte „PORTS“ siehst du genau, welcher externe Port auf den internen Port des Containers weitergeleitet wird. Nutze immer den externen Port für die Verbindung.
Der „Dummy-Key“-Hack: Eine Besonderheit von OpenClaw
OpenClaw ist eine junge Software und hat noch einige Eigenheiten im Code („Quirks“). Eine davon betrifft die Authentifizierung bei lokalen oder offenen Modellen.
Die Software ist so programmiert, dass sie für jeden konfigurierten Modell-Provider zwingend einen API-Key in der Datenbank oder den Config-Dateien erwartet. Wenn man nun Ollama nutzt (egal ob lokal oder via Cloud-Proxy), benötigt man technisch gesehen oft keinen API-Key, da die Authentifizierung über den Server-Zugriff oder IP-Whitelisting läuft.
Lässt man das Feld für den API-Key in der auth-profiles.json jedoch leer, verweigert OpenClaw den Start oder stürzt beim Versuch ab, das Modell zu laden. Der Code prüft schlicht: „Ist String vorhanden? Nein -> Fehler.“
Die Lösung: Man muss einen Platzhalter-Wert eintragen.
Es ist völlig egal, was dort steht, solange etwas dort steht. Bewährt hat sich ein einfacher String wie dummy, skriptatelier oder ollama.
Der Eintrag in der auth-profiles.json sollte also so aussehen:
- Provider: ollama
- Model: kimi-k2.5
- API Key: „dummy“
OpenClaw liest diesen Schlüssel, ist zufrieden, dass ein Wert vorhanden ist, und sendet die Anfrage an die oben konfigurierte Docker-Bridge-IP. Der Ollama-Server ignoriert den Dummy-Key einfach und verarbeitet die Anfrage. Dies ist ein klassischer Workaround, der zeigt, wie wichtig ein tiefes Verständnis der KI Integration auf Code-Ebene ist.
Zusammenfassung des Low-Cost-Setups
Durch diese Kombination erreichen wir ein extrem leistungsfähiges System zu minimalen Kosten:
- Infrastruktur: Ein günstiger VPS (ca. 5-10€) hostet OpenClaw und sorgt für 24/7-Verfügbarkeit.
- Intelligenz: Kimi k2.5 liefert Top-Performance, vergleichbar mit teuren US-Modellen.
- Anbindung: Die NVIDIA API (kostenlos/günstig) oder Ollama Cloud (Flatrate) übernehmen die schwere Rechenlast.
- Verbindung: Über die Docker-Bridge-IP (
172.17.0.1) kommunizieren die Komponenten sicher miteinander.
Dieses Setup senkt die Betriebskosten von potenziell 1000 Euro im Monat (bei reiner Nutzung von Claude Opus) auf unter 30 Euro, ohne dass der Agent an Autonomie verliert. Er kann weiterhin nachts „aufwachen“, E-Mails prüfen und Aufgaben erledigen, da der „Heartbeat“ finanziell nicht mehr ins Gewicht fällt.
Sicherheit und Datenhoheit: Isolierung ist Pflicht
Wer einem autonomen Agenten Zugriff auf sein digitales Leben gibt, hantiert mit einem zweischneidigen Schwert. Auf der einen Seite steht massive Produktivität, auf der anderen das Risiko, dass ein Stück Software versehentlich wichtige Daten löscht, Firmengeheimnisse teilt oder durch eine Fehlkonfiguration Tür und Tor für Angriffe öffnet. Sicherheit ist bei KI-Agenten kein optionales Feature, sondern das absolute Fundament.
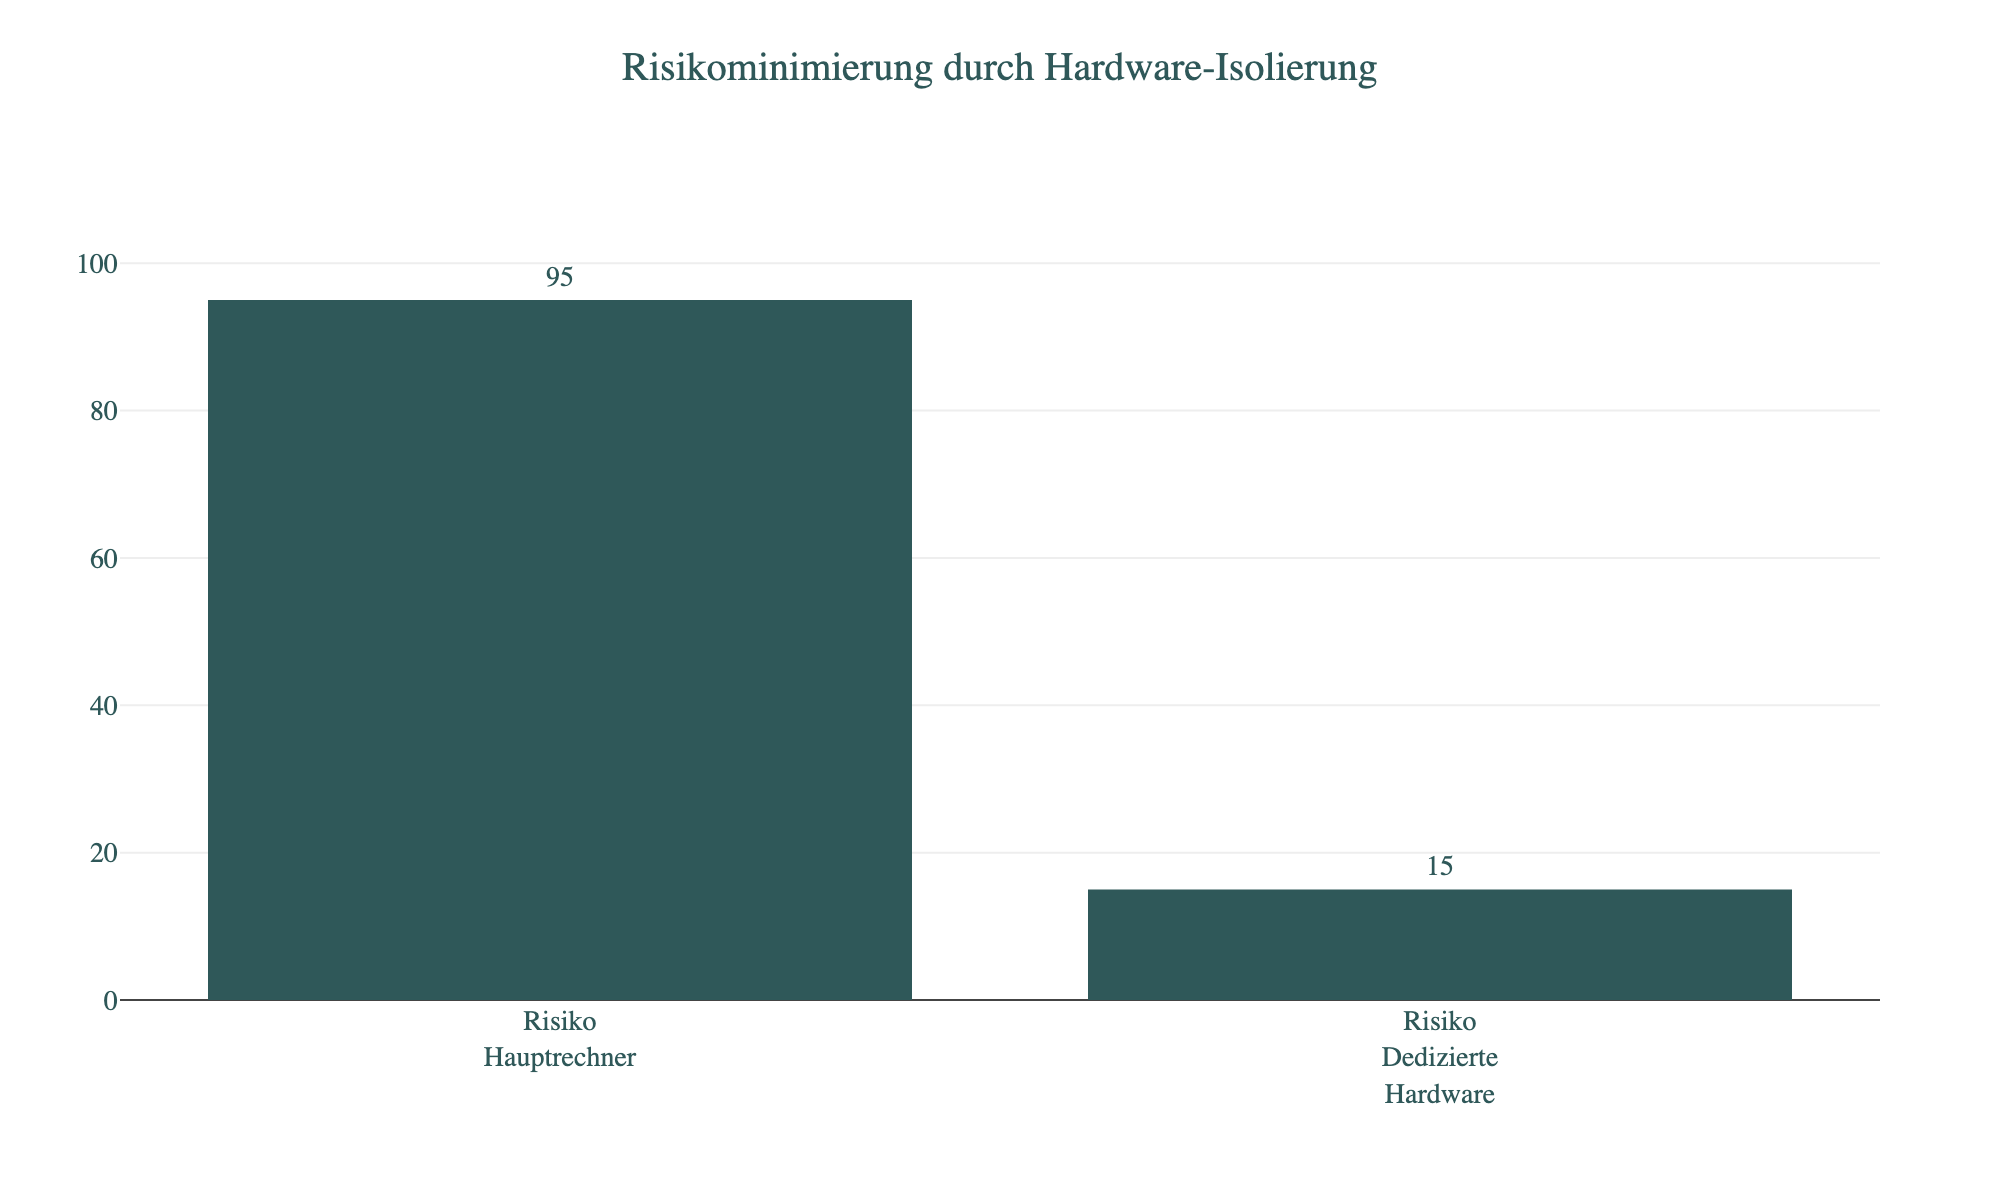
Ein KI-Agent wie OpenClaw ist technisch gesehen kein einfacher Chatbot mehr. Er ist eine Anwendung mit Ausführungsrechten. Er kann Dateien schreiben, E-Mails versenden und Code ausführen. Wenn man diesen Agenten auf dem gleichen Laptop laufen lässt, auf dem auch das Online-Banking, die privaten Urlaubsfotos und die Steuererklärungen der letzten zehn Jahre liegen, handelt man grob fahrlässig. Die einzige vernünftige Strategie lautet: Radikale Isolierung.
Dedizierte Hardware: Der Mac Mini als „Safe Space“
Die sicherste Firewall ist physikalische Trennung. Es empfiehlt sich dringend, den Agenten nicht auf dem Hauptarbeitsrechner zu installieren. Ein Fehler im Skript des Agenten könnte dazu führen, dass er rekursiv Verzeichnisse löscht oder Dateien überschreibt. Auf einem produktiven Rechner wäre das eine Katastrophe.
Die Lösung ist ein dedizierter Server oder Computer, der physikalisch bei einem im Büro steht, aber logisch komplett vom restlichen Netzwerk getrennt agiert. Ein Mac Mini (vorzugsweise mit Apple Silicon M-Chip) hat sich hier als idealer „Safe Space“ erwiesen. Er bietet genug Rechenleistung für lokale Modelle (wie im vorherigen Kapitel besprochen), verbraucht kaum Strom und läuft extrem stabil.
Das Prinzip der „Clean Slate“
Man nimmt diesen Mac Mini und setzt ihn komplett neu auf. Wichtig ist dabei, was man nicht tut: 1. Keine iCloud-Synchronisation: Man meldet sich zwar mit einer Apple-ID an (für Updates), deaktiviert aber konsequent die Synchronisation von Fotos, Notizen, Schlüsselbund und Desktop-Dateien. Der Agent darf keinen Zugriff auf die private Cloud haben. 2. Kein Zugriff auf das Haupt-Netzwerk: Im Idealfall hängt dieser Rechner in einem Gast-WLAN oder einem separaten VLAN (Virtual Local Area Network). Sollte der Agent kompromittiert werden, kann sich der Angreifer nicht auf die Firmenserver oder NAS-Systeme ausbreiten. 3. Keine sensiblen Dateien: Auf der Festplatte dieses Rechners liegen ausschließlich das Betriebssystem, die Agenten-Software (OpenClaw) und temporäre Arbeitsdateien.
Diese Hardware-Isolierung schützt vor dem „Rogue Agent“-Szenario. Wenn der Agent durch eine fehlerhafte Anweisung („Lösche alle Dateien, die älter als 2 Tage sind“) Amok läuft, löscht er nur seine eigenen temporären Daten, nicht aber die Buchhaltung.
Separate Google-Accounts: Identitäts-Isolierung statt Admin-Zugriff
Viele Nutzer machen den Fehler, dem Agenten ihren eigenen Google-Account zu geben, damit er Zugriff auf Kalender und E-Mails hat. Das ist bequem, aber gefährlich. Wenn man OpenClaw autorisiert, erhält die Software oft weitreichende Rechte (Scopes). Ein Fehler im Token-Handling oder ein Hack der Agenten-Software könnte theoretisch vollen Zugriff auf das gesamte digitale Leben gewähren.
Der professionelle Weg ist die Erschaffung eines „Digitalen Mitarbeiters“. Man legt einen völlig neuen Google Workspace Account an, zum Beispiel .
Das Prinzip der minimalen Rechte (Least Privilege)
Dieser neue Account hat standardmäßig Zugriff auf nichts. Er ist leer. Nun teilt man explizit nur die Ressourcen, die der Agent wirklich braucht: * Kalender: Man gibt den eigenen Hauptkalender für den Agenten-Account frei, aber vielleicht nur mit der Berechtigung „Termine ändern“, nicht „Einstellungen verwalten“. * Drive: Man erstellt einen Ordner „KI-Inbox“ und teilt nur diesen einen Ordner mit dem Agenten. Alles, was der Agent bearbeiten soll, schiebt man dort hinein. Alles, was er erstellt, landet dort. Der Rest des Google Drives bleibt für ihn unsichtbar. * E-Mail: Der Agent sendet E-Mails nur von seiner eigenen Adresse. Wenn er im Namen des Chefs schreiben soll, bereitet er Entwürfe vor, sendet sie aber nicht ab.
Diese Trennung hat einen weiteren Vorteil: Transparenz. In den Protokollen von Google Workspace sieht man genau: „Geändert von Agent Schmidt“. Nutzt der Agent den Account des Chefs, lässt sich später nicht mehr nachvollziehen, ob eine E-Mail von der KI oder vom Menschen gelöscht wurde. Dies ist auch ein wichtiger Aspekt, wenn man die KI Integration in Unternehmen rechtssicher gestalten will.
Der „Wettbewerber-Test“ für sensible Daten
Selbst mit perfekter Hardware und getrennten Accounts bleibt die Frage: Was darf ich der KI eigentlich erzählen? OpenClaw nutzt im Hintergrund oft LLMs (Large Language Models) von Anbietern wie Anthropic oder OpenAI, sofern man nicht komplett lokal läuft. Zwar versichern diese Anbieter, Daten von API-Kunden nicht für das Training zu nutzen, doch Restrisiken durch Hacks oder Datenlecks bleiben bestehen.
Hier hilft eine einfache mentale Heuristik für jeden Mitarbeiter: Der Wettbewerber-Test.
Bevor man Daten in den Prompt eingibt oder ein Dokument in den geteilten Ordner lädt, stellt man sich folgende Frage:
„Würde ich dieses Dokument in einen Briefumschlag stecken und unverschlüsselt per Post an unseren größten Wettbewerber schicken?“
- Wenn die Antwort „Vielleicht unangenehm, aber kein Weltuntergang“ lautet (z.B. bei öffentlichen Marketingtexten, allgemeinen Branchenanalysen, Code-Snippets für Standard-Funktionen), dann darf die KI damit arbeiten.
- Wenn die Antwort „Auf gar keinen Fall, das ruiniert uns“ lautet (z.B. Kundenlisten mit Umsatzzahlen, Patentanträge, Passwörter, Mitarbeiter-Gehaltslisten), dann sind diese Daten für den Agenten tabu.
Gerade im Hinblick auf den kommenden EU AI Act 2026 wird der Umgang mit sensiblen Daten durch KI-Systeme streng reguliert werden. Wer jetzt schon strikte Trennung übt, spart sich später teure Compliance-Projekte.
Nutzung von Umgebungsvariablen für API-Keys
Ein technischer, aber absolut kritischer Punkt ist der Umgang mit Zugangsdaten (Credentials). Wenn OpenClaw auf Tools wie Notion, Google oder Twitter zugreifen soll, benötigt es API-Keys. Das sind lange Zeichenketten, die wie Passwörter funktionieren.
Ein absolutes No-Go ist es, diese Keys direkt in den Chat zu posten („Hier ist mein API Key, bitte verbinde dich mit Notion…“) oder sie fest in den Code zu schreiben (Hardcoding). Chatverläufe werden gespeichert, oft in Klartext-Datenbanken oder Logs. Wer Zugriff auf diese Logs bekommt, hat Zugriff auf alle verknüpften Dienste.
Die .env Datei als Tresor
Die einzig saubere Lösung ist die Nutzung von Umgebungsvariablen (Environment Variables).
1. Speicherung: Man legt auf dem Mac Mini oder Server eine Datei namens .env an. Diese Datei liegt im Wurzelverzeichnis der Agenten-Software.
2. Inhalt: In dieser Datei stehen die Schlüssel in der Form NOTION_API_KEY=secret_12345.
3. Zugriff: Die Software OpenClaw liest diese Variablen beim Starten aus dem Arbeitsspeicher des Systems. Sie tauchen nirgendwo im Chatverlauf oder in der Benutzeroberfläche auf.
Sollte jemand den Chatverlauf hacken, findet er dort keine Schlüssel. Sollte jemand den Code des Agenten auf GitHub sehen, fehlen die Schlüssel ebenfalls, da die .env Datei niemals öffentlich geteilt wird (sie steht auf der sogenannten .gitignore Liste).
Auch autonome KI-Agenten müssen sich an diese Standards der Softwareentwicklung halten. Sicherheit entsteht nicht durch Hoffnung, sondern durch saubere Architektur.
Exkurs: Monitoring und „Kill Switch“
Zur Datenhoheit gehört auch die Kontrolle. Ein autonomes System braucht Überwachung. Auf dem dedizierten Mac Mini sollte ein einfaches Monitoring laufen, das den Netzwerk-Traffic überwacht. Wenn der Agent plötzlich anfängt, Gigabytes an Daten an eine unbekannte IP-Adresse zu senden, muss das auffallen.
Man sollte zudem immer einen „Not-Aus-Schalter“ haben. Das kann so simpel sein wie der Stecker des Mac Mini oder ein Befehl im Terminal (docker stop openclaw), der den Container sofort beendet. Wer Automatisierung ohne Notbremse baut, riskiert, dass aus einem kleinen Fehler eine Endlosschleife mit massiven Kosten oder Datenverlust wird.
Zusammenfassend lässt sich sagen: Isolierung ist kein Zeichen von Misstrauen gegenüber der Technik, sondern die Voraussetzung für ihren professionellen Einsatz. Nur wer seine Datenräume sauber trennt, kann die PS der KI wirklich auf die Straße bringen, ohne in der nächsten Kurve aus der Bahn geworfen zu werden. Mit diesem Sicherheitsnetz im Rücken können wir uns nun den fortgeschrittenen Workflows widmen, bei denen der Agent nicht nur reagiert, sondern komplexe Werkzeugketten bedient.
Fortgeschrittene Workflows: Agent und Tools kombinieren
Ein KI-Assistent, der nur chattet, ist im Grunde ein glorifizierter Suchschlitz. Die wahre Magie der Automatisierung entsteht erst, wenn der Agent die Fesseln des Textfensters sprengt und direkten Zugriff auf Werkzeuge, APIs und externe Software erhält. In diesem Kapitel geht es darum, wie man OpenClaw oder ähnliche Frameworks von einem passiven Antwortgeber zu einem aktiven Operator macht, der komplexe Aufgabenketten (Chains) selbstständig abarbeitet.
Wir betrachten hierbei keine theoretischen Spielereien, sondern harte Produktions-Workflows: Von der marktorientierten Datenanalyse über die automatisierte Softwareentwicklung bis hin zur dynamischen Modell-Steuerung.
Datengestützte Konkurrenzanalyse via YouTube API
Viele Unternehmen nutzen KI lediglich, um Zusammenfassungen zu erstellen. Ein fortgeschrittener Workflow dreht den Spieß um: Der Agent beschafft sich die Daten selbst, analysiert sie statistisch und liefert handlungsrelevante Insights. Ein perfektes Beispiel hierfür ist die automatisierte Marktbeobachtung auf YouTube, um Content-Lücken oder Trends zu identifizieren.
Anstatt manuell durch Kanäle zu klicken, stattet man den Agenten mit einem Python-Skript und einem API-Schlüssel für die YouTube Data API v3 aus. Der Workflow läuft autonom ab:
- Zieldefinition: Man gibt dem Agenten den Auftrag: „Analysiere die letzten 50 Videos von Kanal X und finde Ausreißer (Outlier), die signifikant besser performen als der Durchschnitt.“
- Code-Generierung & Ausführung: Der Agent schreibt nicht nur den Text, sondern generiert im Hintergrund ein Python-Skript. Dieses Skript zieht sich via API die Metadaten (Views, Likes, Veröffentlichungsdatum) der Videos.
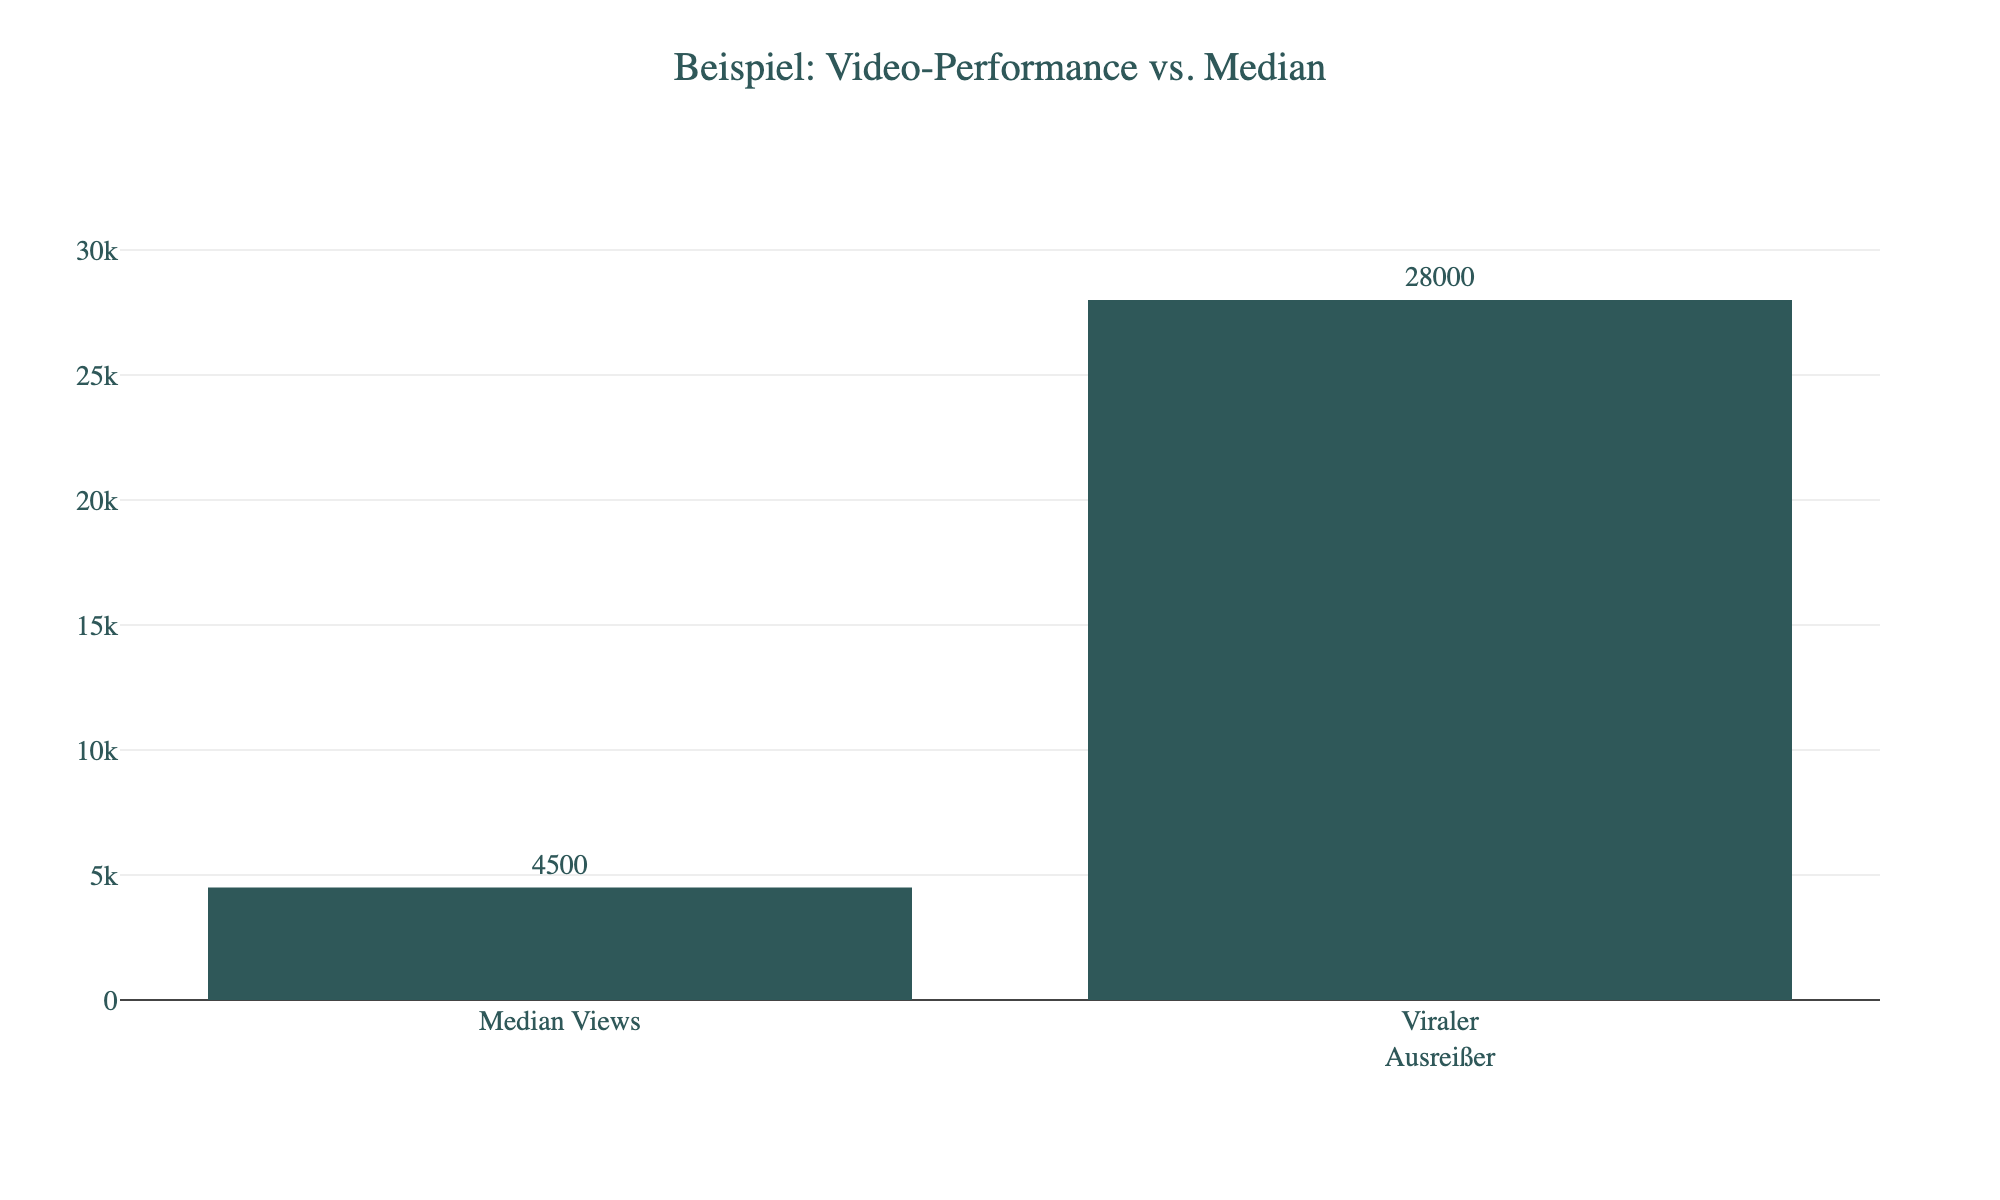
- Statistische Auswertung: Der Agent berechnet den Median der Aufrufe (nicht den Durchschnitt, um Verzerrungen durch virale Hits zu vermeiden).
- Filterung: Das Skript filtert alle Videos heraus, deren Aufrufzahlen beispielsweise 200 % über dem Median liegen.
Das Ergebnis ist keine bloße Liste, sondern eine qualifizierte Analyse. Der Agent erkennt Muster: „Videos zum Thema ‚Heizungsgesetz‘ performen auf diesem Kanal 3x besser als Videos zu ‚Dämmung‘.“
Dieser Ansatz lässt sich auf nahezu jede Datenquelle übertragen: SEO-Daten aus der Search Console, Finanzdaten via Alpha Vantage oder Ticket-Statistiken aus Jira. Wer mehr über die strategische Einbindung solcher Prozesse erfahren möchte, findet im Leitfaden zur KI Integration in Unternehmen vertiefende Ansätze.
Arbeitsteilung: Der Agent als Manager, CLI-Tools als Coder
Ein häufiges Missverständnis bei der Nutzung von KI-Agenten in der individuellen Softwareentwicklung ist der Glaube, das Sprachmodell (LLM) müsse den gesamten Code selbst schreiben und im Chat ausgeben. Das ist ineffizient und fehleranfällig, da das Kontextfenster (das Kurzzeitgedächtnis der KI) schnell überläuft und Token-Kosten explodieren.
Ein wesentlich leistungsfähigerer Ansatz ist die Trennung von Planung und Ausführung. Hierbei fungiert OpenClaw als technischer Projektleiter (Manager), während spezialisierte Command Line Interface (CLI) Tools die eigentliche Arbeit verrichten.
Das Manager-Worker-Modell
In diesem Setup hat der Agent Zugriff auf das Terminal des Servers oder Containers. Er nutzt Tools wie sed, grep oder spezialisierte Coding-Assistenten, die via CLI steuerbar sind.
Der Prozess sieht wie folgt aus:
- Spezifikation: Der Agent erstellt einen Plan. Er analysiert die Anforderung (z. B. „Erstelle eine Landingpage mit Kontaktformular“) und bricht sie in Teilschritte herunter. Er schreibt diese Schritte in eine
TODO.mdDatei. - Delegation: Statt den HTML-Code im Chat zu generieren, führt der Agent einen Befehl aus, um eine Datei zu erstellen. Er nutzt
echooder schreibt direkt in die Datei. - Validierung: Der Agent führt Tests aus. Er ruft beispielsweise einen Linter auf oder startet den Server, um zu sehen, ob Fehler geworfen werden.
- Korrektur: Liest der Agent eine Fehlermeldung im Terminal, korrigiert er gezielt nur die betroffene Zeile im Code, anstatt die gesamte Datei neu zu generieren.
Ein mächtiges Werkzeug in dieser Konstellation ist die Integration von Aider oder ähnlichen CLI-basierten Coding-Tools innerhalb des Agenten-Workflows. Der Agent sagt dem Tool: „Füge in index.html ein div mit der Klasse .container hinzu“. Das Tool führt den Edit chirurgisch präzise durch. Das hält den Kontext des Agenten sauber, da er nicht den gesamten Code im Gedächtnis behalten muss, sondern nur die Dateistruktur und den aktuellen Status.
Dies ist besonders relevant, wenn man komplexe Systeme wie Headless Commerce Plattformen wartet, wo kleine Änderungen in großen Codebases an der Tagesordnung sind.
Multi-Model-Strategie über Router konfigurieren
Wie bereits im Abschnitt zu den Kosten angerissen, ist die Nutzung eines einzigen „Super-Modells“ (wie Claude Opus) für alle Aufgaben wirtschaftlicher Selbstmord. Die technische Lösung hierfür ist ein sogenannter Model Router. In fortgeschrittenen Setups von OpenClaw oder ähnlichen Agenten lässt sich dieser Router granular konfigurieren.
Das Ziel ist es, die „Intelligenz“ der Aufgabe anzupassen. Man schießt nicht mit Kanonen auf Spatzen.
Konfiguration des Routers
Der Router entscheidet anhand von Regeln, welches Modell für den nächsten Schritt verwendet wird. Diese Regeln basieren oft auf Schlüsselwörtern, Aufgaben-Typen oder der Komplexität des Prompts.
| Aufgabentyp | Empfohlenes Modell | Begründung |
|---|---|---|
| Logik & Architektur | Claude 3.5 Sonnet / GPT-4o | Benötigt hohes Verständnis für Zusammenhänge und Planung. |
| Code-Generierung | DeepSeek Coder V2 / Claude 3.5 Sonnet | Spezialisiert auf Syntax und logische Strukturen in Code. |
| Routine & Heartbeat | Gemini 1.5 Flash / Haiku | Extrem schnell und günstig. Perfekt für „Gibt es neue E-Mails?“ |
| Kreatives Schreiben | Claude 3 Opus | Bester natürlicher Sprachfluss, relevant für Blogposts oder Marketing-Mails. |
In der config.json oder den Router-Einstellungen des Agenten definiert man diese Weichen. Ein vereinfachtes Logik-Beispiel:
- WENN Input enthält „Plane“, „Analysiere“, „Architektur“ -> NUTZE High-Intelligence-Model.
- WENN Input enthält „Prüfe“, „Liste auf“, „Status“ -> NUTZE Low-Cost-Model.
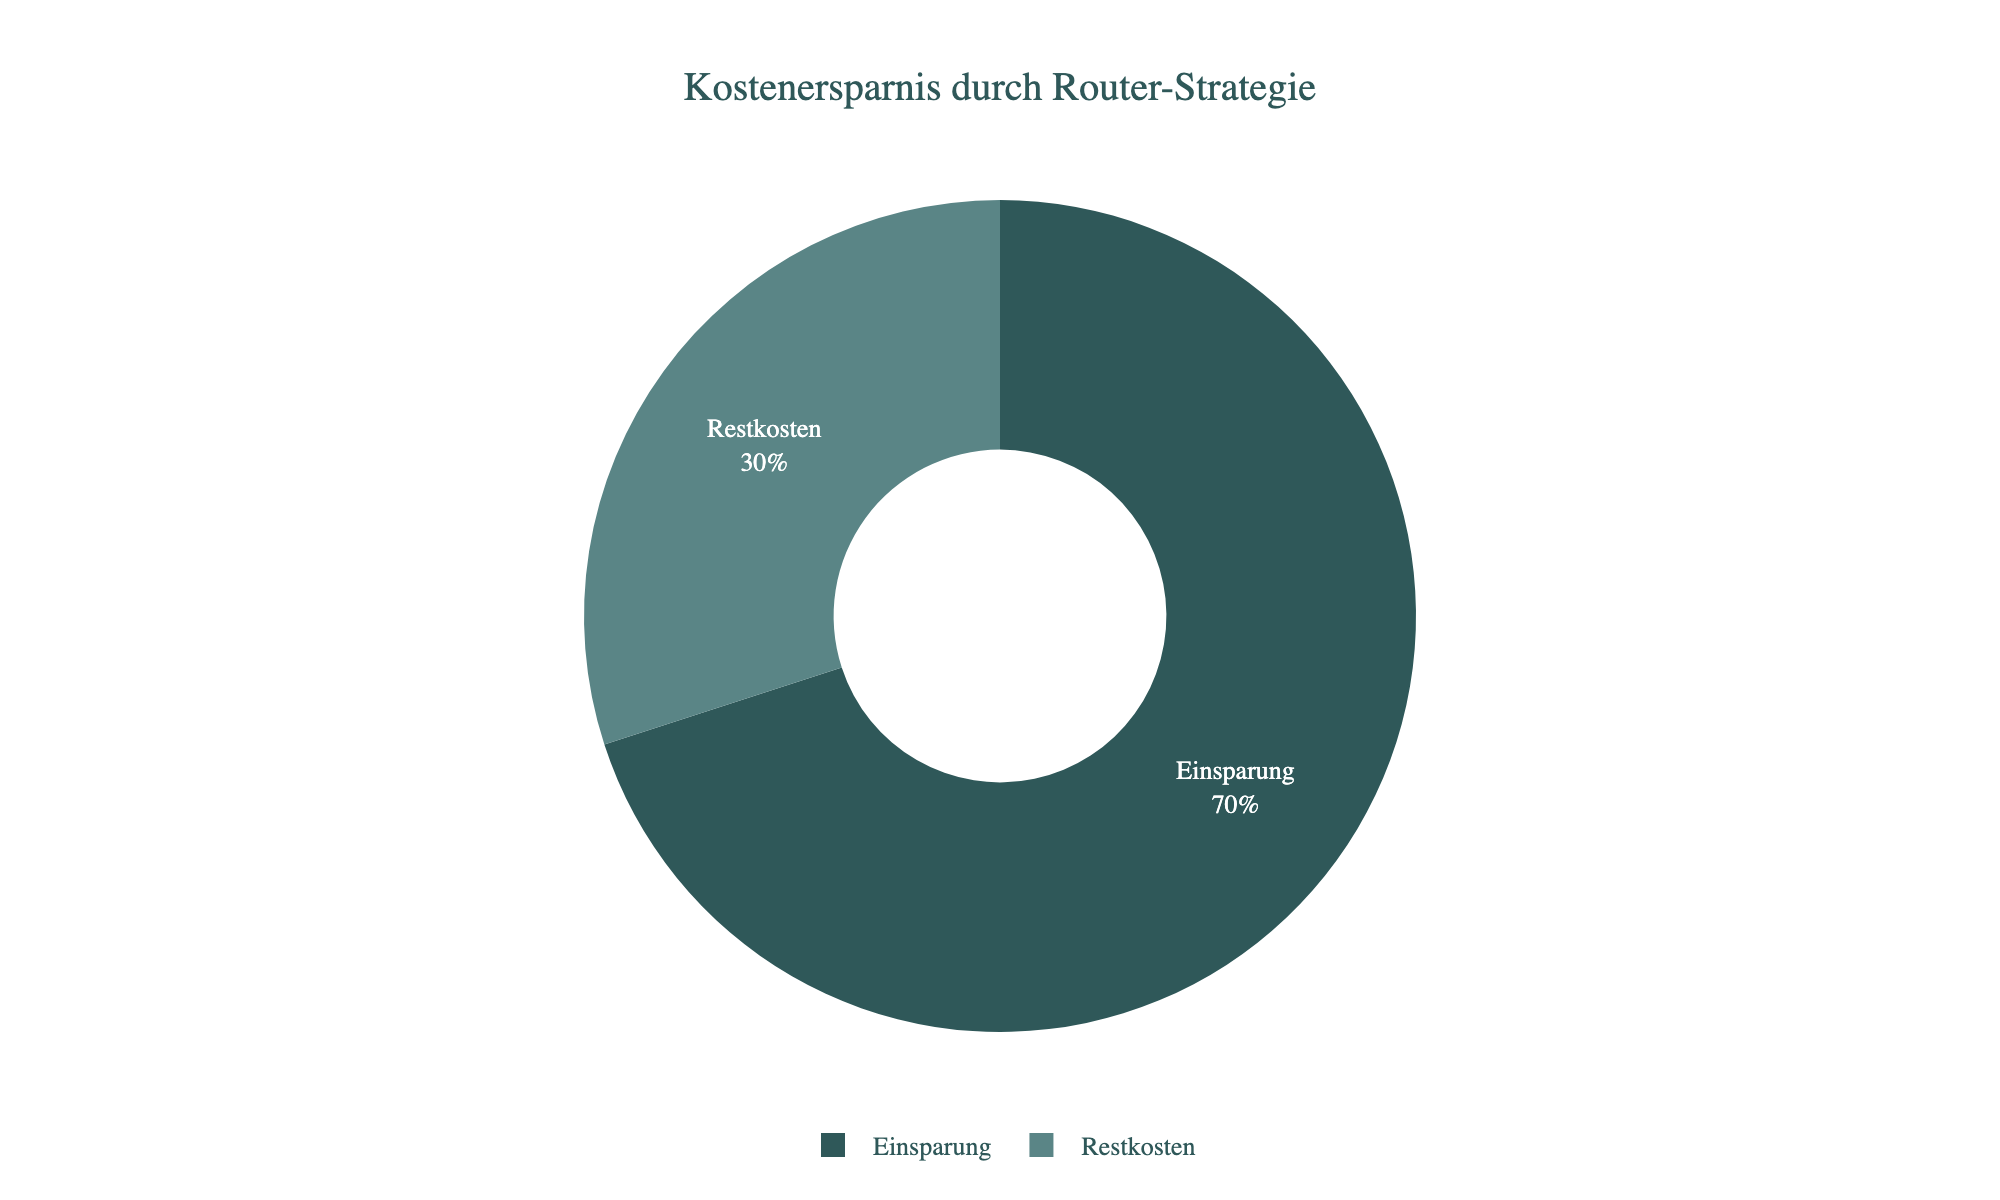
Diese Strategie ist essenziell, um 24/7-Agenten profitabel zu betreiben. Gerade bei Aufgaben wie der kontinuierlichen SEO Optimierung, wo der Agent täglich hunderte Keywords prüfen könnte, summieren sich die Einsparungen durch günstige Modelle massiv.
Autonome Selbstheilung (Self-Healing Workflows)
Der „Heilige Gral“ fortgeschrittener Workflows ist die Fähigkeit zur Selbstheilung. In klassischen Automatisierungen bricht ein Skript ab, wenn ein Fehler auftritt. Ein KI-Agent hingegen kann den Fehler „lesen“ und darauf reagieren.
Stellen wir uns vor, der Agent soll eine Responsive Website deployen.
1. Der Agent führt das Deployment-Skript aus.
2. Das Terminal meldet: Error: Package 'sass' not found.
3. Ein dummes Skript würde hier stoppen.
4. Der Agent nimmt den Output stderr, erkennt das fehlende Paket, führt selbstständig npm install sass aus und startet das Deployment erneut.
Diese Schleife, Action -> Observation -> Reason -> Action, macht den Unterschied zwischen einem starren Skript und einem resilienten digitalen Mitarbeiter aus. Je besser man die „Tools“ (Terminal, Browser, Editor) in die Umgebung des Agenten integriert, desto robuster werden diese Selbstheilungskräfte.
Es empfiehlt sich, solche Workflows zunächst in einer sicheren Sandbox zu testen, bevor man sie auf Produktionsserver loslässt. Die Kombination aus intelligentem Routing, Arbeitsteilung via CLI und Zugriff auf externe APIs macht aus einem einfachen Chatbot ein mächtiges Werkzeug für die digitale Wertschöpfung.
Fazit
OpenClaw zeigt eindrucksvoll, dass die Zukunft der KI nicht im reinen Chat, sondern im autonomen Handeln liegt. Wer bereit ist, die anfängliche Komplexität der Einrichtung zu überwinden, erhält einen digitalen Mitarbeiter, der Routineaufgaben zuverlässig abnimmt. Dabei ist der Wechsel von teuren Cloud-Modellen zu lokalen Lösungen wie Ollama oder Kimi entscheidend, um die Betriebskosten langfristig gering zu halten und das System wirtschaftlich zu betreiben.
Gleichzeitig darf man die Sicherheit nicht vernachlässigen. Da der Agent weitreichende Zugriffsrechte benötigt, sollte man ihn strikt von sensiblen Geschäftsdaten isolieren. Ein dedizierter Server oder ein separates Benutzerkonto sind Pflicht, um Risiken zu minimieren. Mit der richtigen Balance aus Leistung und Schutz wird aus der technischen Spielerei ein mächtiger Wettbewerbsvorteil, der rund um die Uhr für das Unternehmen arbeitet.
Quellen
Video-Quelle 1: OpenClaw in der Praxis – Use Cases und Setup.
URL: https://www.youtube.com/watch?v=a_SkNoVXBCo&pp=ygUXb3BlbiBjbGF3IGtvc3RlbiBzZW5rZW4%3D
Video-Quelle 2: OpenClaw effizient betreiben mit Kimi und Ollama.
URL: https://www.youtube.com/watch?v=Le4oP-3mFes
Video-Quelle 3: Praxistest und Sicherheitsstrategien für AI-Agenten.
URL: https://www.youtube.com/watch?v=e2gwL_v63_I&pp=ygUXb3BlbiBjbGF3IGtvc3RlbiBzZW5rZW4%3D
OpenClaw GitHub Repository: Der offizielle Quellcode und die Dokumentation für den autonomen Agenten (ehemals Moltbot/Clawdbot). Hier finden sich Installationsanweisungen und Updates.
URL: https://github.com/openclaw/openclaw
Ollama Dokumentation: Technische Referenz für die lokale Ausführung von LLMs. Dies ist essenziell, um Modelle wie Llama 3 oder Mistral ohne Cloud-Kosten auf eigener Hardware zu betreiben.
URL: https://ollama.com
Anthropic API Pricing: Die offizielle Preisliste für die Claude-Modelle (Opus, Sonnet, Haiku). Dient als Referenz für die Kostenkalkulation im Vergleich zum Self-Hosting.
URL: https://www.anthropic.com/pricing
NVIDIA NIM: Plattform von NVIDIA, die Entwicklern Zugriff auf optimierte KI-Modelle bietet und oft kostenlose Credits zum Testen bereitstellt.
URL: https://build.nvidia.com