
Künstliche Intelligenz ist längst keine Zukunftsmusik mehr, sondern der Motor der aktuellen industriellen Revolution. Dennoch beobachtet man in Deutschland oft ein seltsames Phänomen. Während sich die Technologie rasend schnell weiterentwickelt, verharren viele Unternehmen in einer abwartenden Haltung. Man liest zwar täglich von ChatGPT und Co., doch die produktive Einbindung in die Kernprozesse bleibt oft aus. Es liegt selten an den fehlenden technischen Möglichkeiten, sondern meist an strategischer Unsicherheit. Die Frage ist heute nicht mehr, ob man KI einsetzen sollte, sondern wie man es tut, ohne sich dabei die Finger oder das Budget zu verbrennen. Wer jetzt zögert, lässt riesige Effizienzpotenziale liegen und überlässt innovativeren Marktteilnehmern das Feld.
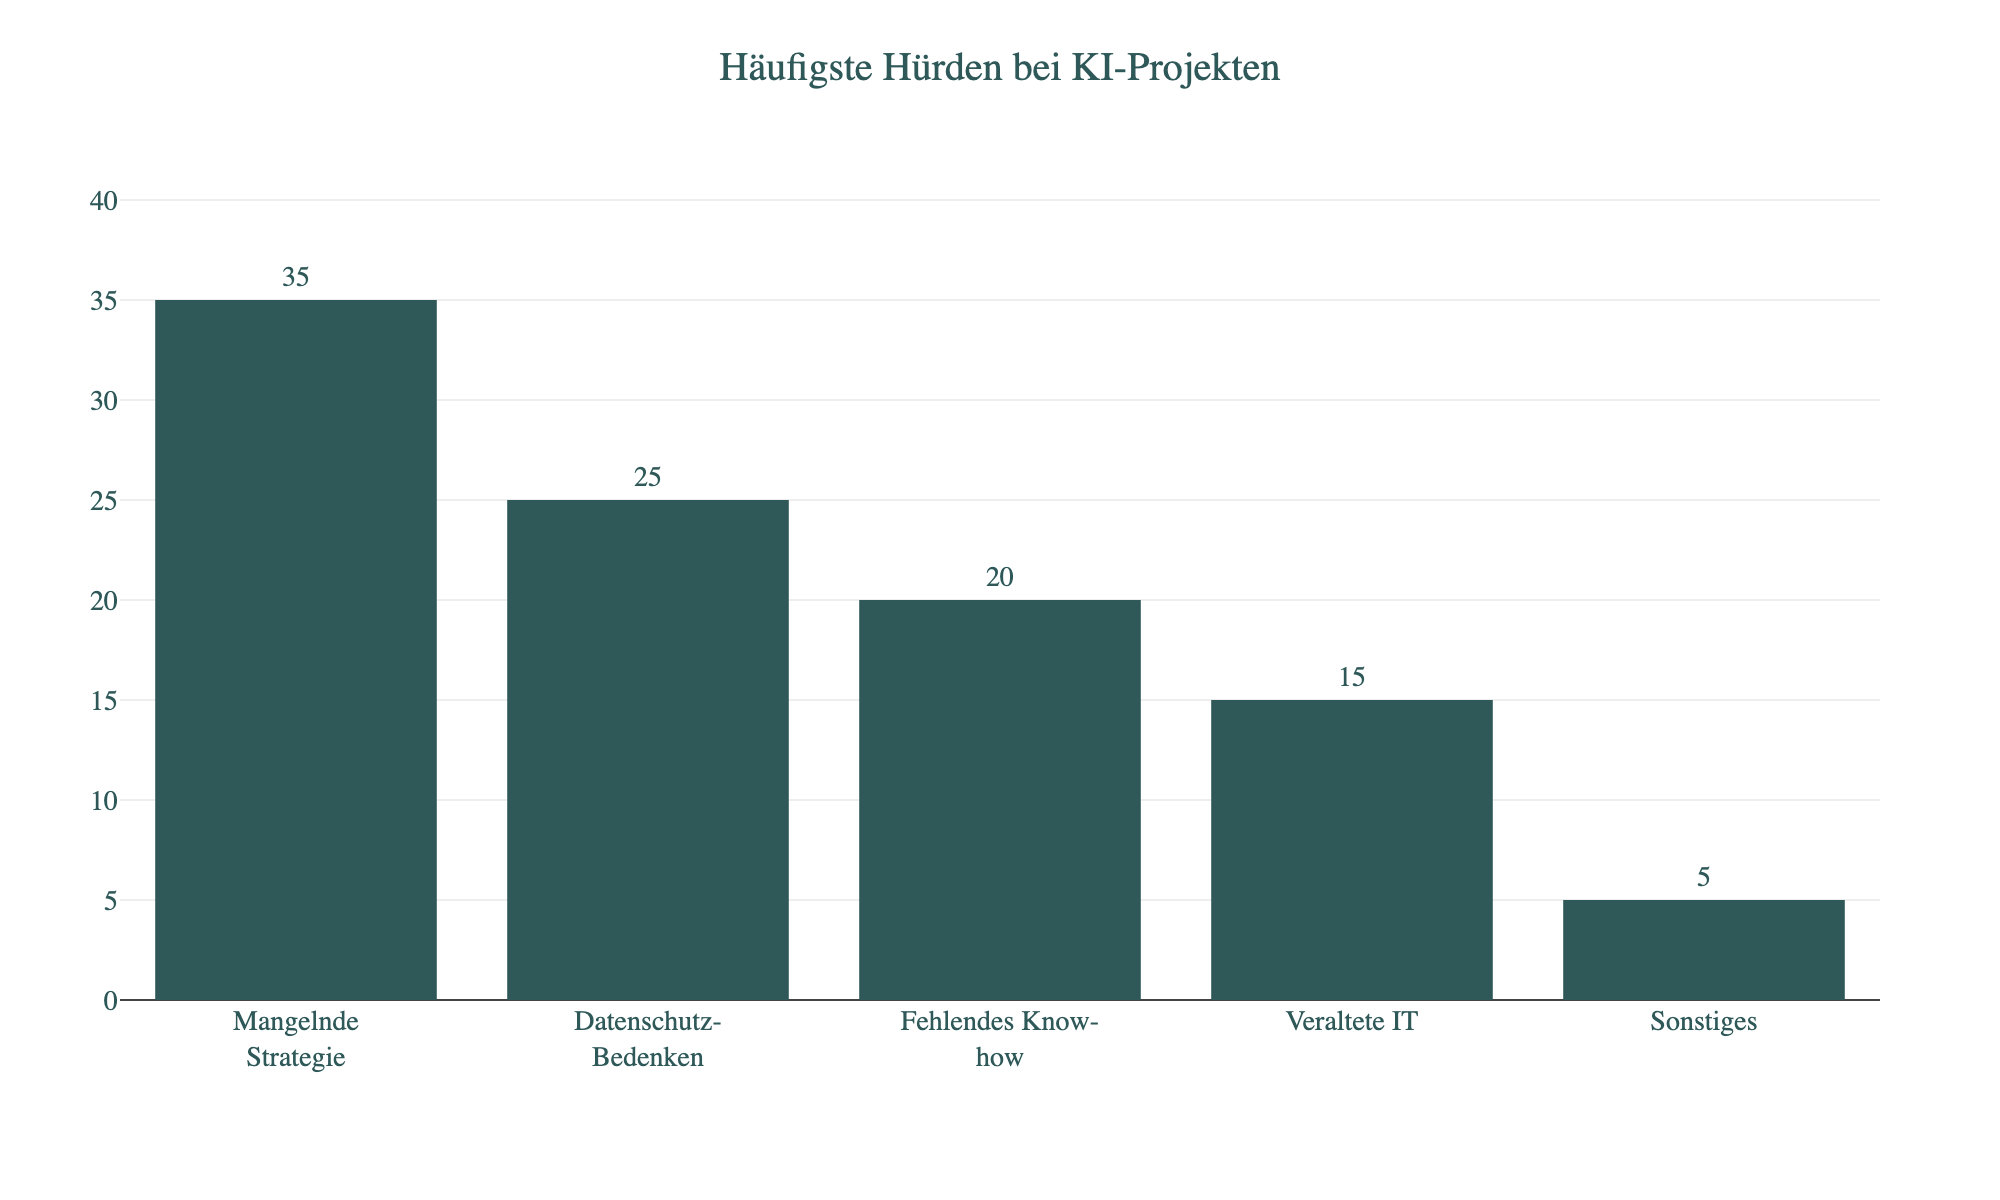
Die Hürden sind dabei häufig hausgemacht und liegen tief in den Strukturen begründet. Man sieht Datensilos, die über Jahrzehnte gewachsen sind und nun über Nacht als Basis für High-Tech-Algorithmen dienen sollen. Hinzu kommt oft eine Unternehmenskultur, in der die Angst vor dem Ersetztwerden die Neugier erstickt. Auch der Datenschutz spielt eine zentrale Rolle. Die deutsche Gründlichkeit, sonst ein Qualitätsmerkmal, wird hier oft zum Bremsklotz, wenn man die DSGVO als pauschale Ausrede nutzt, um Innovationen zu verhindern. Doch genau diese Denkweise ist gefährlich. Die internationale Konkurrenz schläft nicht und nutzt diese Werkzeuge bereits, um schneller, besser und kosteneffizienter zu arbeiten.
Um erfolgreich zu sein, muss man verstehen, dass KI kein reines IT-Projekt ist, das man an eine Fachabteilung delegiert. Es ist ein Thema für die Geschäftsführung und muss strategisch verankert sein. Es betrifft das Marketing, wo Texte in Sekunden generiert werden können. Es verändert den Kundensupport, wo Bots mittlerweile echte Dialoge führen. Und es revolutioniert den Büroalltag, wo Protokolle und Analysen automatisiert entstehen. Die Effizienzgewinne sind messbar und massiv. Wer dies ignoriert, riskiert nicht nur, einen technischen Trend zu verpassen, sondern gefährdet seine Wettbewerbsfähigkeit für die nächsten Jahre massiv.
Es ist daher an der Zeit, die theoretische Laborphase zu verlassen und strikt auf die Praxis zu schauen. Wie kommt man von einem netten Testprojekt zu einer echten, wertschöpfenden Anwendung? Wie löst man das Datenschutz-Thema rechtssicher, ohne eine Batterie an Anwälten zu beschäftigen? Und welche Tools helfen im B2B-Sektor wirklich weiter? Im Folgenden betrachten wir genau diese Punkte. Von der Vermeidung typischer Projekt-Fallen bis hin zu konkreten Prompts für den Workflow geht es darum, Technologie nutzbar zu machen. Man muss lernen, pragmatisch, rechtskonform und vor allem gewinnbringend mit der neuen Intelligenz zu arbeiten.
Inhalt
Strategische Hürden: Warum KI-Projekte oft scheitern
KI-Projekte scheitern selten an der Komplexität der Algorithmen oder der fehlenden Rechenpower. Der Hauptgrund für das Scheitern liegt fast immer in einer Diskrepanz zwischen technologischer Vision und geschäftlicher Realität. Wenn Unternehmen KI als reines IT-Experiment betrachten und nicht als strategischen Hebel, der auf konkrete Unternehmensziele einzahlt, sind Fehlschläge vorprogrammiert. Es fehlt oft nicht an Daten, sondern an einer klaren Antwort auf die Frage: Welches betriebswirtschaftliche Problem lösen wir hier eigentlich und wer bezahlt die Rechnung, wenn der erste Hype verflogen ist?
Das fehlende Management-Buy-in und die Kunst des internen Marketings
Ein weitverbreitetes Missverständnis in deutschen Mittelstandsunternehmen ist die Annahme, dass gute Technologie für sich selbst spricht. Das ist ein fataler Irrtum. In vielen Firmen sitzen brillante Data-Science-Teams oder engagierte IT-Abteilungen, die technisch beeindruckende Modelle entwickeln. Sie bauen Vorhersagemodelle für Maschinenausfälle oder automatisieren komplexe Klassifizierungen. Doch diese Projekte versanden oft in der Bedeutungslosigkeit.
Der Grund dafür ist simpel. Die Sprache der Techniker und die Sprache des Managements sind grundverschieden. Während der Entwickler von „98 Prozent Genauigkeit beim F1-Score“ spricht, fragt sich der Geschäftsführer oder Abteilungsleiter: „Spart mir das Geld? Bringt es mir Umsatz? Oder kostet es mich nur Nerven?“.
Wenn die KI Integration in Unternehmen erfolgreich sein soll, muss die technische Ebene lernen, ihre Arbeit intern zu verkaufen. Ein KI-Projekt ist im Grunde ein Start-up innerhalb des eigenen Konzerns. Es konkurriert mit anderen Abteilungen um Budget, Ressourcen und Aufmerksamkeit. Ohne ein starkes „internes Marketing“ wird das Projekt bei der ersten Budgetkürzung gestrichen.
Es reicht nicht, im stillen Kämmerlein zu entwickeln und das Ergebnis dann über den Zaun zu werfen. Man muss aktiv auf die Entscheidungsträger zugehen. Das bedeutet, Ergebnisse müssen in Währungen übersetzt werden, die das Management versteht: Zeitersparnis in Stunden, Kostensenkung in Euro oder Umsatzsteigerung in Prozentpunkten.
Ein weiterer Aspekt des Management-Buy-ins ist das Erwartungsmanagement. KI wird in den Medien oft als Wundermittel dargestellt. Wenn die Realität dann zeigt, dass ein Algorithmus auch mal Fehler macht oder Training Zeit benötigt, kippt die Stimmung schnell. Hier ist proaktive Aufklärung nötig. Man muss Führungskräften klarmachen, dass KI-Systeme probabilistisch arbeiten, sie berechnen Wahrscheinlichkeiten, keine absoluten Wahrheiten. Ein System, das 90 Prozent der Routineanfragen korrekt automatisiert, ist ein enormer Gewinn, auch wenn 10 Prozent noch manuell nachbearbeitet werden müssen. Wer jedoch 100 Prozent Perfektion ab Tag eins verspricht, unterschreibt das Todesurteil seines Projekts.
Mach dein Business zukunftsfähig!
<mit smarter KI-Nutzung und cleverer Automatisierung nehmen wir dir Arbeit ab und schaffen Raum für das Wesentliche>
Lass dich kostenlos beraten
Die „Proof of Concept“-Hölle vermeiden
In der Branche gibt es einen gefürchteten Begriff für den Zustand vieler deutscher KI-Initiativen. Die „PoC-Hölle“ (Proof of Concept Hell). Das Szenario ist fast immer gleich. Ein Unternehmen möchte innovativ sein. Man stellt ein Budget bereit, um „mal zu schauen, was mit KI geht“. Es werden fünf, zehn oder zwanzig kleine Testprojekte gestartet. Man baut einen Chatbot für die Kantine, eine Bilderkennung für den Parkplatz und eine kleine Analyse für die Lagerbestände.
Alle diese Projekte laufen als Pilotphasen. Man klopft sich auf die Schulter, weil man modern ist. Doch nach sechs Monaten stellt man fest. Keines dieser Projekte ist im produktiven Betrieb. Sie laufen auf den Laptops der Entwickler oder in isolierten Cloud-Umgebungen, aber sie sind nicht in die Kernprozesse der Firma integriert. Sie erwirtschaften keinen Mehrwert.
Der Weg aus der PoC-Hölle erfordert eine radikale Änderung der Denkweise. Die Devise darf nicht lauten „Let’s start exploring“, sondern muss heißen „Start finishing“. Es ist wirtschaftlich sinnvoller, ein einziges Projekt konsequent bis zur vollen Integration durchzuziehen, als zehn Projekte halbfertig liegenzulassen.
Ein Vom Chatbot zum digitalen Kollegen entwickelter Prozess entsteht nicht durch Spielerei, sondern durch harte Integrationsarbeit. Der Schritt vom Prototyp zum Produkt ist oft der teuerste Teil des Projekts. Hier geht es um Schnittstellen, Sicherheit, Wartbarkeit und Skalierung. Wer das Budget nur für den PoC einplant und die Integrationskosten vergisst, wird scheitern.
Ein PoC sollte daher niemals ohne einen definierten „Path to Production“ gestartet werden. Bevor die erste Zeile Code geschrieben wird, müssen folgende Fragen geklärt sein. 1. Was ist das Kriterium für einen Erfolg? (KPIs) 2. Wer übernimmt die Verantwortung (Ownership) für das Tool, wenn es fertig ist? 3. Wie sieht die technische Integration in die bestehende IT-Landschaft aus?
Wenn diese Fragen nicht beantwortet werden können, sollte das Projekt gar nicht erst gestartet werden. Unternehmen müssen lernen, Projekte frühzeitig zu beerdigen („Fail fast“), wenn sie diese Kriterien nicht erfüllen, um Ressourcen auf die gewinnbringenden Themen zu konzentrieren.
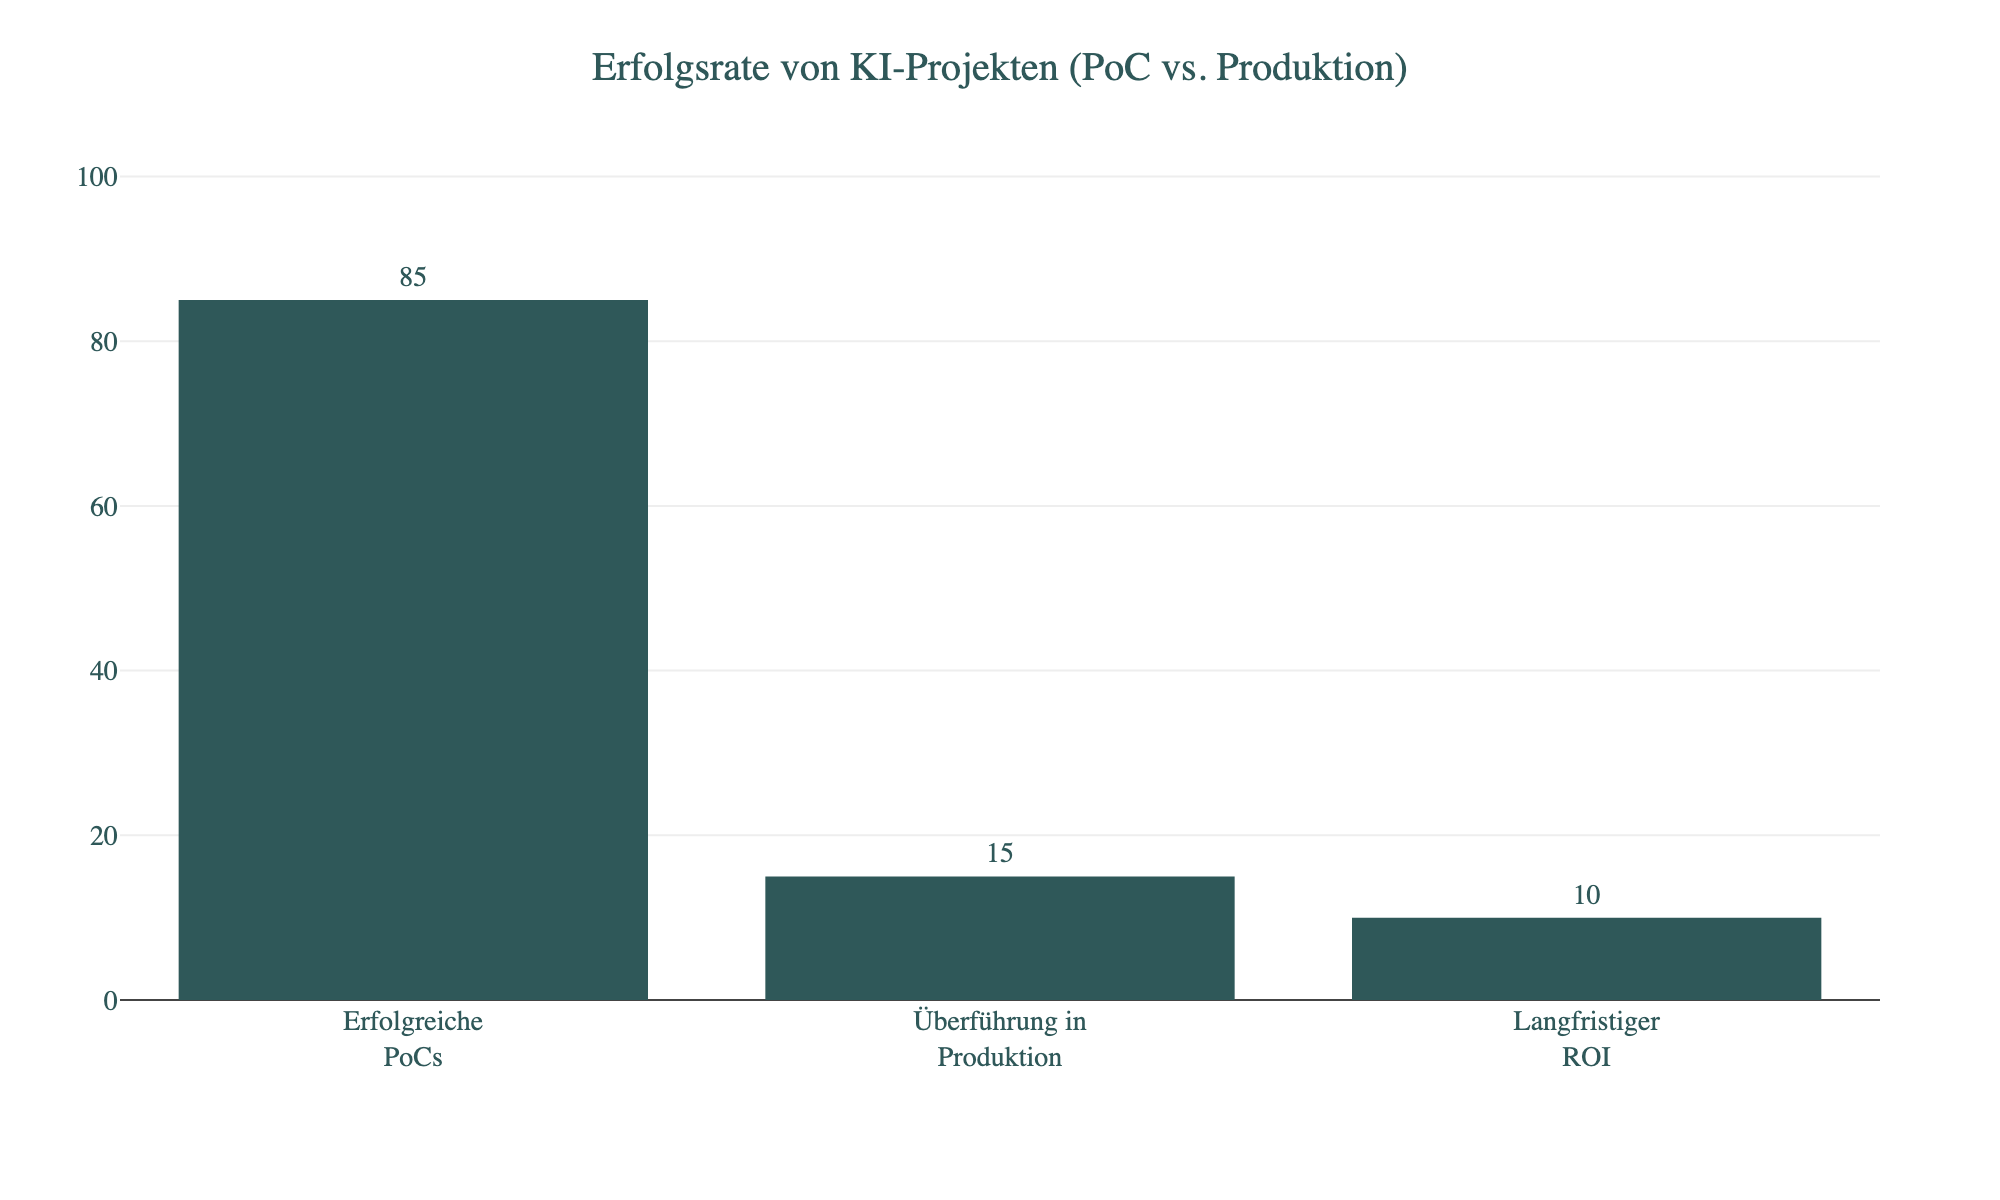
Diese Diskrepanz zwischen erfolgreichen Tests und tatsächlicher Produktion ist alarmierend. Sie zeigt, dass technisch oft vieles möglich ist, was organisatorisch dann doch nicht umgesetzt wird. Die Gründe reichen von Datenschutzbedenken, die zu spät geprüft wurden, bis hin zu fehlenden Schnittstellen in veralteten ERP-Systemen.
Priorisierung nach Business Impact und Machbarkeit
Da Ressourcen, sowohl Budget als auch Fachkräfte, im Mittelstand begrenzt sind, ist die Auswahl der richtigen Schlachtfelder entscheidend. Viele Unternehmen begehen den Fehler, sich von der technologischen Machbarkeit leiten zu lassen („Was können wir mit den Daten machen?“), anstatt vom geschäftlichen Bedarf auszugehen („Welches Problem müssen wir dringend lösen?“).
Eine professionelle Individuelle Softwareentwicklung und KI-Implementierung benötigt eine klare Priorisierungsmatrix. Man kann nicht alles gleichzeitig machen. Bewährt hat sich hierbei die Bewertung potenzieller Use Cases anhand von zwei Hauptachsen.
- Business Impact (Geschäftswert): Wie hoch ist der potenzielle Nutzen?
- Spart es direkte Kosten?
- Erhöht es den Umsatz?
- Reduziert es signifikant Risiken?
- Ease of Implementation (Machbarkeit): Wie schwer ist die Umsetzung?
- Sind die Daten vorhanden und sauber?
- Haben wir das Know-how?
- Gibt es rechtliche Hürden?
Idealerweise sucht man nach den „Quick Wins“. Das sind Projekte mit hohem Geschäftswert und einfacher Machbarkeit. Leider stürzen sich viele Unternehmen auf „Moonshots“ (hoher Wert, aber extrem schwer umzusetzen) oder, noch schlimmer, auf „Money Pits“ (geringer Wert, schwere Umsetzung, aber technologisch interessant).
Um Objektivität in diesen Auswahlprozess zu bringen, lohnt sich der Einsatz von Scoring-Modellen wie dem ICE-Score (Impact, Confidence, Ease).
- Impact (Auswirkung): Wenn es funktioniert, wie groß ist der Effekt? (Skala 1-10)
- Confidence (Zuversicht): Wie sicher sind wir, dass es technisch klappt und der Impact eintritt? (Skala 1-10)
- Ease (Einfachheit): Wie schnell und günstig können wir es bauen? (Skala 1-10)
Man multipliziert diese Werte. Das Projekt mit dem höchsten Score gewinnt. Dies verhindert, dass das „Lieblingsprojekt“ des Chefs umgesetzt wird, obwohl es objektiv wenig Sinn ergibt.
Ein Beispiel aus der Praxis. Ein Maschinenbauer möchte KI nutzen. * Idee A: Eine KI, die vollautomatisch neue Maschinenteile konstruiert. (Impact: 10, Confidence: 2, Ease: 1 = Score 20). * Idee B: Eine KI, die den Kundensupport bei der Ersatzteilidentifikation unterstützt, indem sie Fotos von defekten Teilen abgleicht. (Impact: 6, Confidence: 8, Ease: 8 = Score 384).
Obwohl Idee A visionärer klingt, ist Idee B der logische Startpunkt. Sie ist machbar, bringt sofortigen Nutzen und baut Vertrauen in die Technologie auf. Sobald solche Systeme laufen und Geld sparen, entsteht der finanzielle Freiraum, um sich später an die komplexeren Themen zu wagen.
Ein weiterer strategischer Fehler ist die Unterschätzung der Datenbasis bei der Priorisierung. Oft wird ein Use Case priorisiert, weil er dringend benötigt wird, nur um dann festzustellen, dass die Datenqualität katastrophal ist. Wenn Daten erst monatelang bereinigt werden müssen, sinkt der „Ease“-Faktor massiv. Daher gehört ein kurzer „Data Audit“ zwingend zur Priorisierungsphase dazu, bevor Budget freigegeben wird. Ohne saubere Daten wird jedes KI-Projekt, egal wie strategisch wichtig es ist, zur Kostenfalle.
Zusammenfassend lässt sich sagen, dass der Erfolg von KI-Projekten weniger im Code-Editor entschieden wird, als vielmehr im Konferenzraum. Wer es schafft, KI zu entmystifizieren, klare wirtschaftliche Ziele zu definieren und Projekte konsequent nach ROI zu priorisieren, wird den Sprung vom Experiment zur Wertschöpfung schaffen. Es gilt, die Technologie als Werkzeug zu sehen, nicht als Selbstzweck. Wer diese strategische Reife erlangt, für den ist KI kein Hype, sondern der nächste logische Schritt in der Unternehmensentwicklung.
Rechtssicherer Einsatz: Datenschutz und DSGVO
Datenschutz ist im Kontext von KI-Projekten keine binäre Entscheidung zwischen „Ja“ oder „Nein“, sondern eine Frage der korrekten technischen Architektur und vertraglichen Gestaltung. Viele Entscheidungsträger lassen sich von der DSGVO lähmen, dabei definiert sie lediglich die Spielregeln, innerhalb derer man sich sicher bewegen kann. Wer die Mechanismen versteht, verwandelt das abstrakte „Compliance-Risiko“ in eine handhabbare Checkliste.
Das Prinzip „Human in the Loop“: Die rote Linie der DSGVO
Das größte Missverständnis bei der Einführung von KI liegt in der Annahme, der Algorithmus dürfe alles entscheiden. Die Datenschutz-Grundverordnung (DSGVO) zieht in Artikel 22 eine sehr klare Grenze: Es besteht ein Verbot von rein automatisierten Entscheidungen, die dem Betroffenen gegenüber rechtliche Wirkung entfalten oder ihn in ähnlicher Weise erheblich beeinträchtigen.
Das klingt juristisch abstrakt, hat aber massive Auswirkungen auf die Praxis. Ein Algorithmus darf beispielsweise nicht autonom darüber entscheiden, ob ein Mitarbeiter eingestellt, ein Kredit vergeben oder ein Versicherungsvertrag gekündigt wird. Sobald eine Software diese Entscheidung ohne menschliches Zutun trifft und vollstreckt, begibt man sich in eine rechtliche Gefahrenzone.
Die Lösung liegt im Konzept des „Human in the Loop“. Die KI fungiert hierbei nicht als Richter, sondern als Assistent. Sie analysiert Daten, erkennt Muster und liefert eine Entscheidungsempfehlung oder eine Wahrscheinlichkeit. Die finale Handlung, also der Klick auf „Genehmigen“ oder „Ablehnen“, muss durch einen qualifizierten Menschen erfolgen.
Der Unterschied in der Praxis:
- Verboten (in der Regel): Ein Bewerber-Tool scannt Lebensläufe und versendet automatisch Absagen an alle Kandidaten, deren Notenschnitt unter 2,0 liegt. Hier fehlt die menschliche Abwägung.
- Erlaubt (Human in the Loop): Das Tool sortiert Lebensläufe vor und markiert Kandidaten mit „Hoher Passung“ grün und andere rot. Ein Recruiter schaut sich die markierten Profile an und entscheidet dann selbstständig über die Einladung oder Absage.
Damit dieses Konstrukt rechtssicher ist, darf der Mensch nicht nur als „Stempel-August“ fungieren. Er muss die theoretische Möglichkeit und die fachliche Kompetenz haben, das Votum der KI zu überstimmen. Dokumentiert man diesen Prozess sauber, lässt sich KI auch in sensiblen Bereichen wie HR oder Finanzen nutzen.
Der EU AI Act: Risikoklassen statt Pauschalverbot
Mit dem kommenden EU AI Act (KI-Verordnung) wird die Regulierung spezifischer, aber paradoxerweise für viele Unternehmen auch klarer. Der Gesetzgeber verfolgt einen risikobasierten Ansatz. Nicht jede KI wird gleich streng behandelt. Man kann sich das wie eine Pyramide vorstellen: Je höher das Risiko für Grundrechte und Sicherheit, desto strenger die Auflagen.
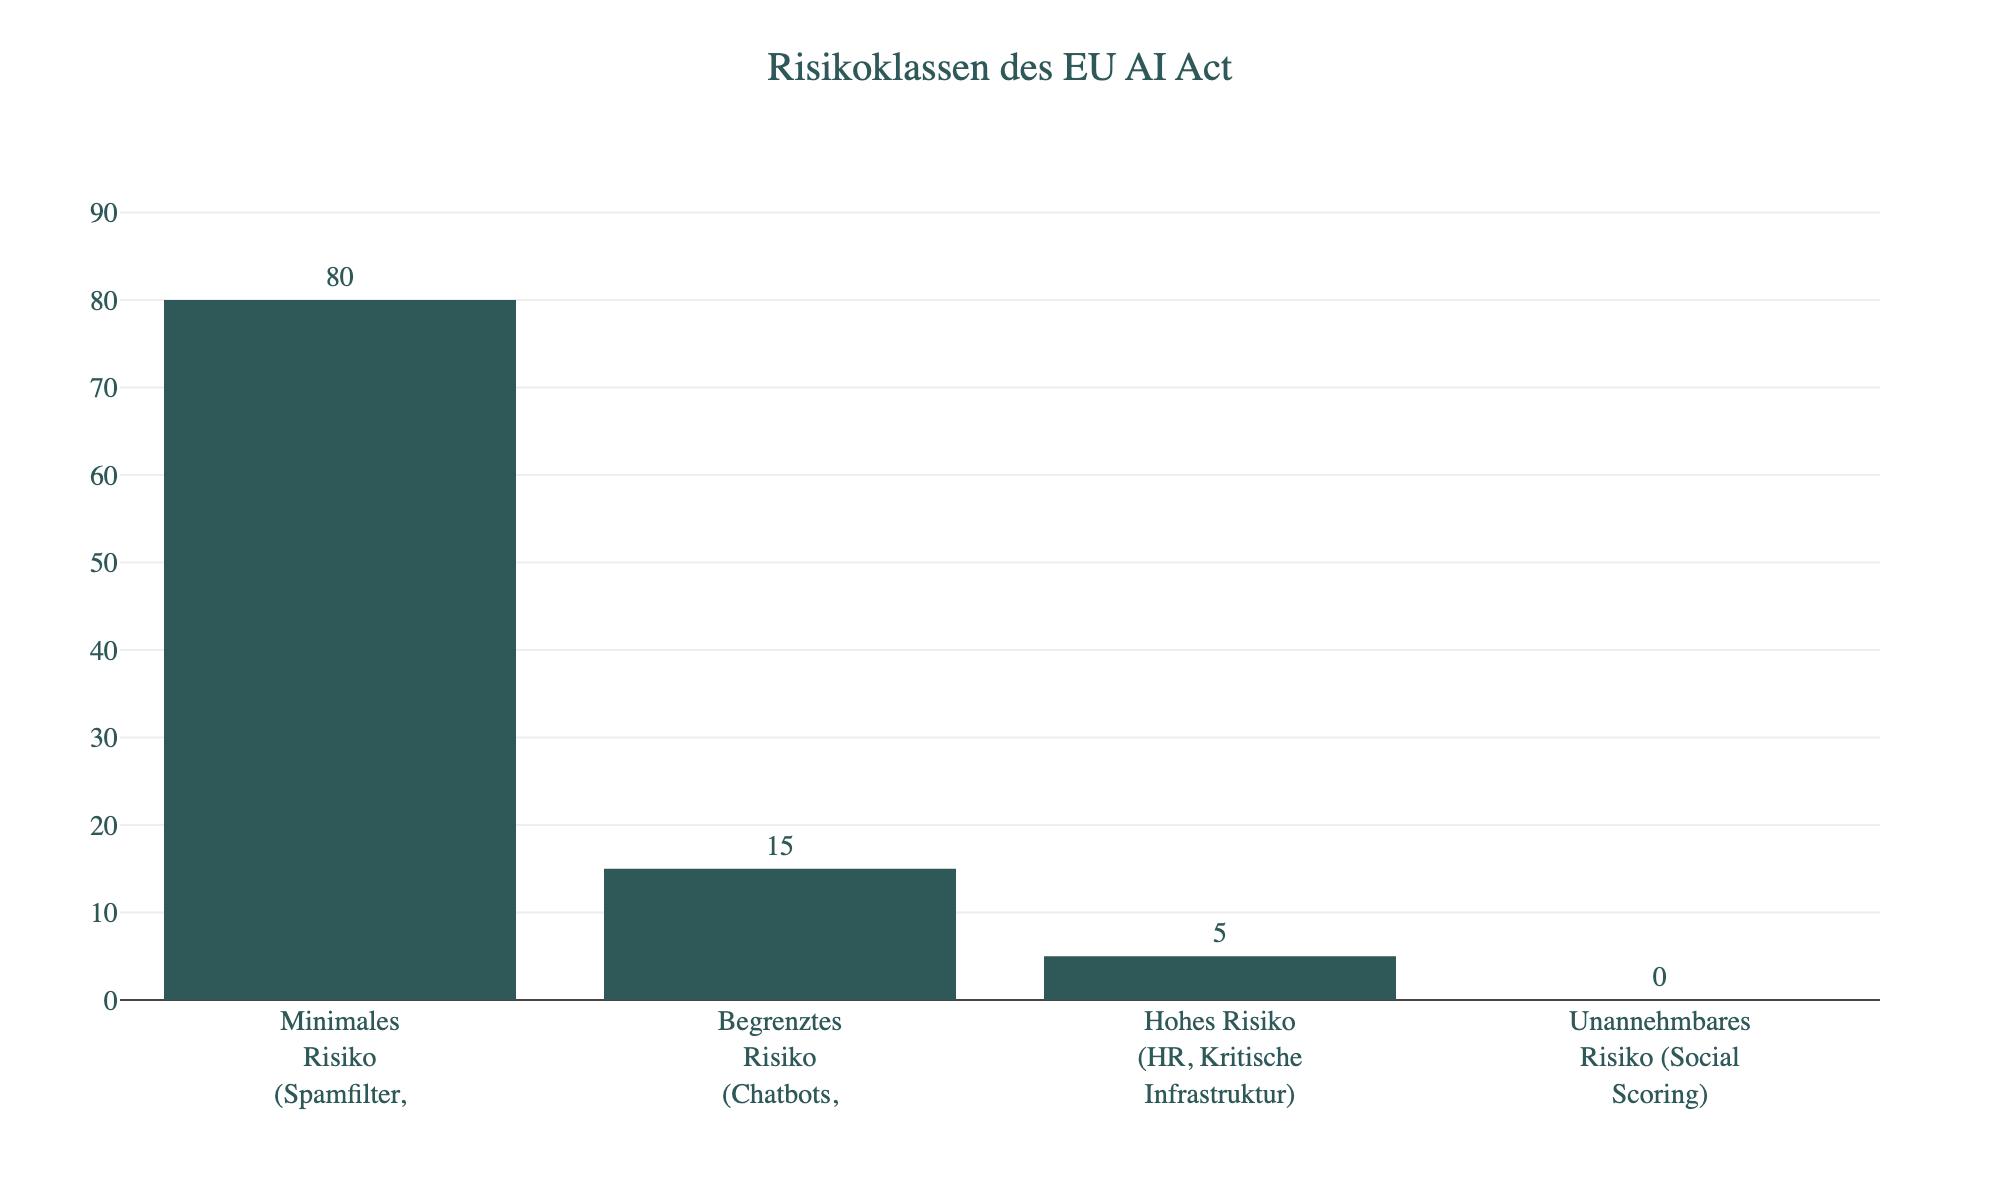
Für den deutschen Mittelstand sind vor allem zwei Kategorien relevant:
- Begrenztes Risiko (Limited Risk): Hierunter fallen die meisten Chatbots und Systeme, die Inhalte generieren (Generative AI). Die Hauptpflicht ist hier Transparenz. Ein Nutzer muss wissen, dass er mit einer Maschine interagiert. Wenn ein Chatbot auf der Website eingesetzt wird, reicht oft ein klarer Hinweis: „Ich bin ein virtueller Assistent“.
- Hohes Risiko (High Risk): Hier wird es komplexer. Dazu zählen KI-Systeme in der kritischen Infrastruktur, in der Bildung (z.B. Bewertung von Prüfungen) oder im Personalwesen (CV-Scanning). Wer solche Systeme einsetzt oder entwickelt, muss umfangreiche Risikomanagement-Systeme etablieren, hohe Datenqualität sicherstellen und genaue technische Dokumentationen vorhalten.
Für Unternehmen, die tief in die Entwicklung eigener Anwendungen einsteigen wollen, ist es essenziell, diese Fristen und Anforderungen frühzeitig zu kennen. Mehr Details zu den Fristen und Sanktionen finden sich in unserem Artikel über den EU AI Act 2026 und die Risiken für KMU.
Bereit, Dein Projekt auf das nächste Level zu bringen?
<Wir sind dein Partner für maßgeschneiderte und individuelle Lösungen. Lass uns gemeinsam deine Vision umsetzen>
Jetzt unverbindlich beraten lassenDas Daten-Dilemma: Training vs. Nutzung (Inference)
Ein technisches Detail, das oft übersehen wird, ist die Trennung zwischen dem Training der KI und der bloßen Nutzung (Inference).
Beim Training lernt das Modell aus riesigen Datenmengen. Bei der Nutzung wendet es dieses Wissen auf neue, ihm unbekannte Daten an. Das datenschutzrechtliche Risiko entsteht primär dann, wenn die Eingaben des Unternehmens (Prompts, hochgeladene Dokumente) dazu verwendet werden, das Modell weiter zu trainieren.
Das Szenario, vor dem IT-Sicherheitsbeauftragte warnen: Ein Mitarbeiter lädt die geheime Patentanmeldung oder die Gehaltsliste in ChatGPT hoch, um eine Zusammenfassung zu erhalten. Wenn das System diese Daten nutzt, um das globale Modell zu verbessern, könnten theoretisch Fragmente dieser Informationen später in den Antworten an andere Nutzer auftauchen. Das ist der Super-GAU für Geschäftsgeheimnisse.
Enterprise-Lizenzen vs. Kostenlose Accounts
Hier trennt sich die Spreu vom Weizen. Die großen KI-Anbieter (OpenAI, Microsoft, Google, Anthropic) haben ein klares Geschäftsmodell: Die kostenlosen „Free Tier“-Versionen finanzieren sich oft quer durch die Nutzung der Daten zur Produktverbesserung. Wer nicht mit Geld bezahlt, bezahlt mit Daten.
Im geschäftlichen Umfeld ist die Nutzung von privaten Free-Accounts daher grob fahrlässig. Sicher wird der Einsatz erst durch Enterprise- oder Team-Lizenzen.
Die Vorteile von Enterprise-Lösungen:
- Zero Data Retention (optional): Viele Anbieter garantieren vertraglich, dass Eingabedaten (Input) und Ausgabedaten (Output) nicht für das Training der Basis-Modelle verwendet werden.
- Server-Standort: Über Anbieter wie Microsoft Azure (OpenAI Service) lassen sich Modelle in europäischen Rechenzentren hosten (z.B. Frankfurt oder Amsterdam). Damit bleiben die Daten im EU-Rechtsraum, was die Argumentation gegenüber Datenschutzbeauftragten massiv erleichtert.
- Auftragsverarbeitungsvertrag (AVV): Nur mit Business-Lizenzen erhält man in der Regel einen standardisierten AVV (Data Processing Addendum), der für die DSGVO-Konformität zwingend erforderlich ist.
Schatten-IT und Mitarbeiter-Sensibilisierung
Das beste technische Setup hilft nichts, wenn Mitarbeiter es umgehen. Da Tools wie ChatGPT oder DeepL privat weit verbreitet sind, nutzen Angestellte diese oft auf dem „kurzen Dienstweg“, wenn keine offiziellen Tools bereitstehen. Man kopiert den Text schnell in das private Browser-Fenster, weil es bequemer ist.
Diesem Phänomen der „Schatten-KI“ begegnet man nicht mit Verboten, sondern mit Alternativen. Wenn das Unternehmen einen sicheren, internen Zugang zu KI-Modellen bereitstellt, entfällt der Grund für die Nutzung unsicherer privater Accounts.
Gleichzeitig müssen klare Richtlinien her. Eine „KI-Policy“ sollte folgende Fragen beantworten: 1. Welche Datenklassen (öffentlich, intern, vertraulich, streng geheim) dürfen in welche Tools eingegeben werden? 2. Wie sind KI-generierte Ergebnisse zu kennzeichnen? 3. Wer haftet bei Fehlern (Halluzinationen) der KI?
Der Sonderweg: Open Source und Self-Hosting
Für Unternehmen mit extrem hohen Anforderungen an den Datenschutz, etwa im Gesundheitswesen, bei Anwaltskanzleien oder in der Forschung, gibt es eine Alternative zu den großen US-Cloud-Anbietern: Self-Hosting von Open-Source-Modellen.
Modelle wie Llama (Meta) oder Mistral (aus Frankreich) haben mittlerweile eine Qualität erreicht, die für viele Aufgaben mit GPT-4 konkurrieren kann. Diese Modelle lassen sich auf eigenen Servern oder bei deutschen Cloud-Hostern (wie Hetzner oder Ionos) betreiben.
Der Vorteil: Die Daten verlassen niemals die eigene Hoheit. Es gibt keinen Datentransfer in die USA, kein Fremdzugriff und völlige Kontrolle über Updates und Verfügbarkeit. Wer beispielsweise eine individuelle Softwareentwicklung anstrebt, sollte prüfen, ob ein integriertes Open-Source-Modell nicht die langfristig sicherere und günstigere Lösung ist.
Auch im Bereich der autonomen Agenten, die Aufgaben selbstständig erledigen, spielt Open Source eine Rolle. Systeme wie OpenClaw zeigen, wie autonome Agenten arbeiten können, ohne auf geschlossene Black-Box-Systeme angewiesen zu sein. Das erhöht die Transparenz und Auditierbarkeit der KI-Entscheidungen massiv.
Pseudonymisierung als letzter Rettungsanker
Wenn cloudbasierte Modelle genutzt werden müssen, aber Personenbezug besteht, ist Pseudonymisierung eine wirksame Technik. Bevor Daten an die KI gesendet werden, ersetzt ein Skript alle Namen, Adressen und Telefonnummern durch Platzhalter (z.B. „Person A“, „Stadt B“). Die KI verarbeitet den anonymisierten Text. Das Ergebnis wird anschließend lokal wieder „re-identifiziert“, indem die Platzhalter durch die echten Daten ersetzt werden.
Dieser Ansatz erfordert zwar technische Integrationsarbeit, ermöglicht aber die Nutzung modernster KI-Intelligenz auch für sensiblere Datensätze, da der US-Anbieter niemals die echten Klarnamen zu Gesicht bekommt.
Zusammenfassend lässt sich sagen: Datenschutz ist kein Showstopper. Er erzwingt lediglich eine Professionalisierung. Weg vom „Rumspielen“ mit kostenlosen Accounts, hin zu vertraglich abgesicherten Enterprise-Umgebungen und klar definierten Prozessen. Wer diese Hausaufgaben macht, kann KI nicht nur legal, sondern auch wettbewerbsüberlegen einsetzen.
Technische Basis: Infrastruktur und Datenqualität
Wer Künstliche Intelligenz erfolgreich im Unternehmen verankern will, muss eine unbequeme Wahrheit akzeptieren: Die beste KI-Strategie ist wertlos, wenn das technische Fundament aus Treibsand besteht. Viele Firmen versuchen, hochmoderne Algorithmen auf eine IT-Infrastruktur aus den frühen 2000ern zu setzen. Das funktioniert nicht. Bevor man über generative KI oder autonome Agenten nachdenkt, muss die Datenbasis bereinigt und die Architektur modernisiert werden. Ohne saubere Daten liefert auch das klügste Modell nur digitalen Müll („Garbage In, Garbage Out“).
Schluss mit dem CSV-Chaos: Warum Excel keine Datenbank ist
In unzähligen deutschen Mittelstandsunternehmen sieht die Realität so aus: Stammdaten liegen im ERP-System, Kundenkontakte in Outlook, Marketing-Leads in einer Excel-Liste auf dem Laufwerk „Z:“ und die Produktionsdaten werden händisch in CSV-Dateien exportiert. Das ist kein „Data Lake“, das ist ein Datensumpf.
Eine KI benötigt strukturierten, maschinenlesbaren Zugriff auf Informationen in Echtzeit. Wenn ein Algorithmus erst darauf warten muss, dass ein Mitarbeiter am Freitagmittag eine Excel-Tabelle aktualisiert und per E-Mail verschickt, ist der Prozess bereits gescheitert. Excel und CSV-Dateien sind für menschliche Analysen oder einmalige Exporte wunderbar, aber giftig für automatisierte KI-Prozesse.
Die Probleme dezentraler Datenspeicherung:
* Versionskonflikte: Wer hat die aktuelle Datei? Kundenliste_Final_v2_NEU.xlsx? Eine KI kann nicht raten, welche Datei die Wahrheit spricht.
* Fehlende Beziehungen: In einer Excel-Tabelle fehlt oft der logische Kontext, der in einer relationalen Datenbank durch Verknüpfungen (Foreign Keys) gesichert ist.
* Sicherheitsrisiken: CSV-Dateien werden oft unverschlüsselt per Mail versendet oder auf USB-Sticks kopiert.
Die Lösung liegt in der Schaffung einer „Single Source of Truth“ (SSOT). Das bedeutet nicht zwingend, dass man sofort ein riesiges Data Warehouse für Millionen Euro bauen muss. Es bedeutet aber, dass man Datensilos aufbricht und Systeme über Schnittstellen (APIs) verbindet, statt Dateien hin- und herzuschieben.
Die API-Economy: Das Nervensystem der KI
Damit KI-Modelle nicht nur isolierte Chatbots bleiben, sondern echte Arbeit verrichten können, müssen sie mit der bestehenden Software-Landschaft kommunizieren. Hier kommen APIs (Application Programming Interfaces) ins Spiel. Eine KI Integration in Unternehmen steht und fällt mit der Qualität dieser Schnittstellen.
Stell dir vor, eine KI soll den Kundensupport unterstützen. Sie muss: 1. Die E-Mail des Kunden lesen (API zum Mailserver). 2. Den Bestellstatus prüfen (API zum ERP/Warenwirtschaftssystem). 3. Die Tracking-ID abrufen (API zum Logistikdienstleister). 4. Eine Antwort formulieren und versenden.
Ohne diese digitalen Brücken ist die KI blind und taub. Wer heute Software einkauft oder entwickeln lässt, muss zwingend auf „API-First“-Ansätze bestehen. Proprietäre Systeme, die keine offenen Schnittstellen bieten, sind Sackgassen für jede Automatisierung. Oft ist hier eine individuelle Softwareentwicklung notwendig, um als „Middleware“ zwischen veralteten Legacy-Systemen und modernen KI-Tools zu vermitteln.
Cloud-Sicherheit vs. lokale Server-Mythen
Ein emotional aufgeladenes Thema in Deutschland ist die Frage: Cloud oder eigener Server im Keller? Hartnäckig hält sich der Mythos, dass Daten auf dem eigenen Server physikalisch sicherer seien. Die Praxis zeigt oft das Gegenteil.
Ein lokaler Server (On-Premise) ist nur so sicher wie das Team, das ihn wartet. * Wer spielt nachts um 3 Uhr das kritische Sicherheits-Update ein, wenn eine neue Zero-Day-Lücke bekannt wird? * Wie ist der Server gegen physischen Einbruch, Feuer oder Wasserschäden geschützt? * Gibt es eine georedundante Datensicherung (Backups an einem anderen Ort)?
Große Cloud-Anbieter (Hyperscaler wie AWS, Azure oder spezialisierte europäische Clouds) beschäftigen Tausende von Sicherheitsingenieuren, die nichts anderes tun, als die Infrastruktur zu härten. Für 99 % der KMUs ist das Sicherheitsniveau einer professionell konfigurierten Cloud-Umgebung um den Faktor 100 höher als das des eigenen Serverraums.
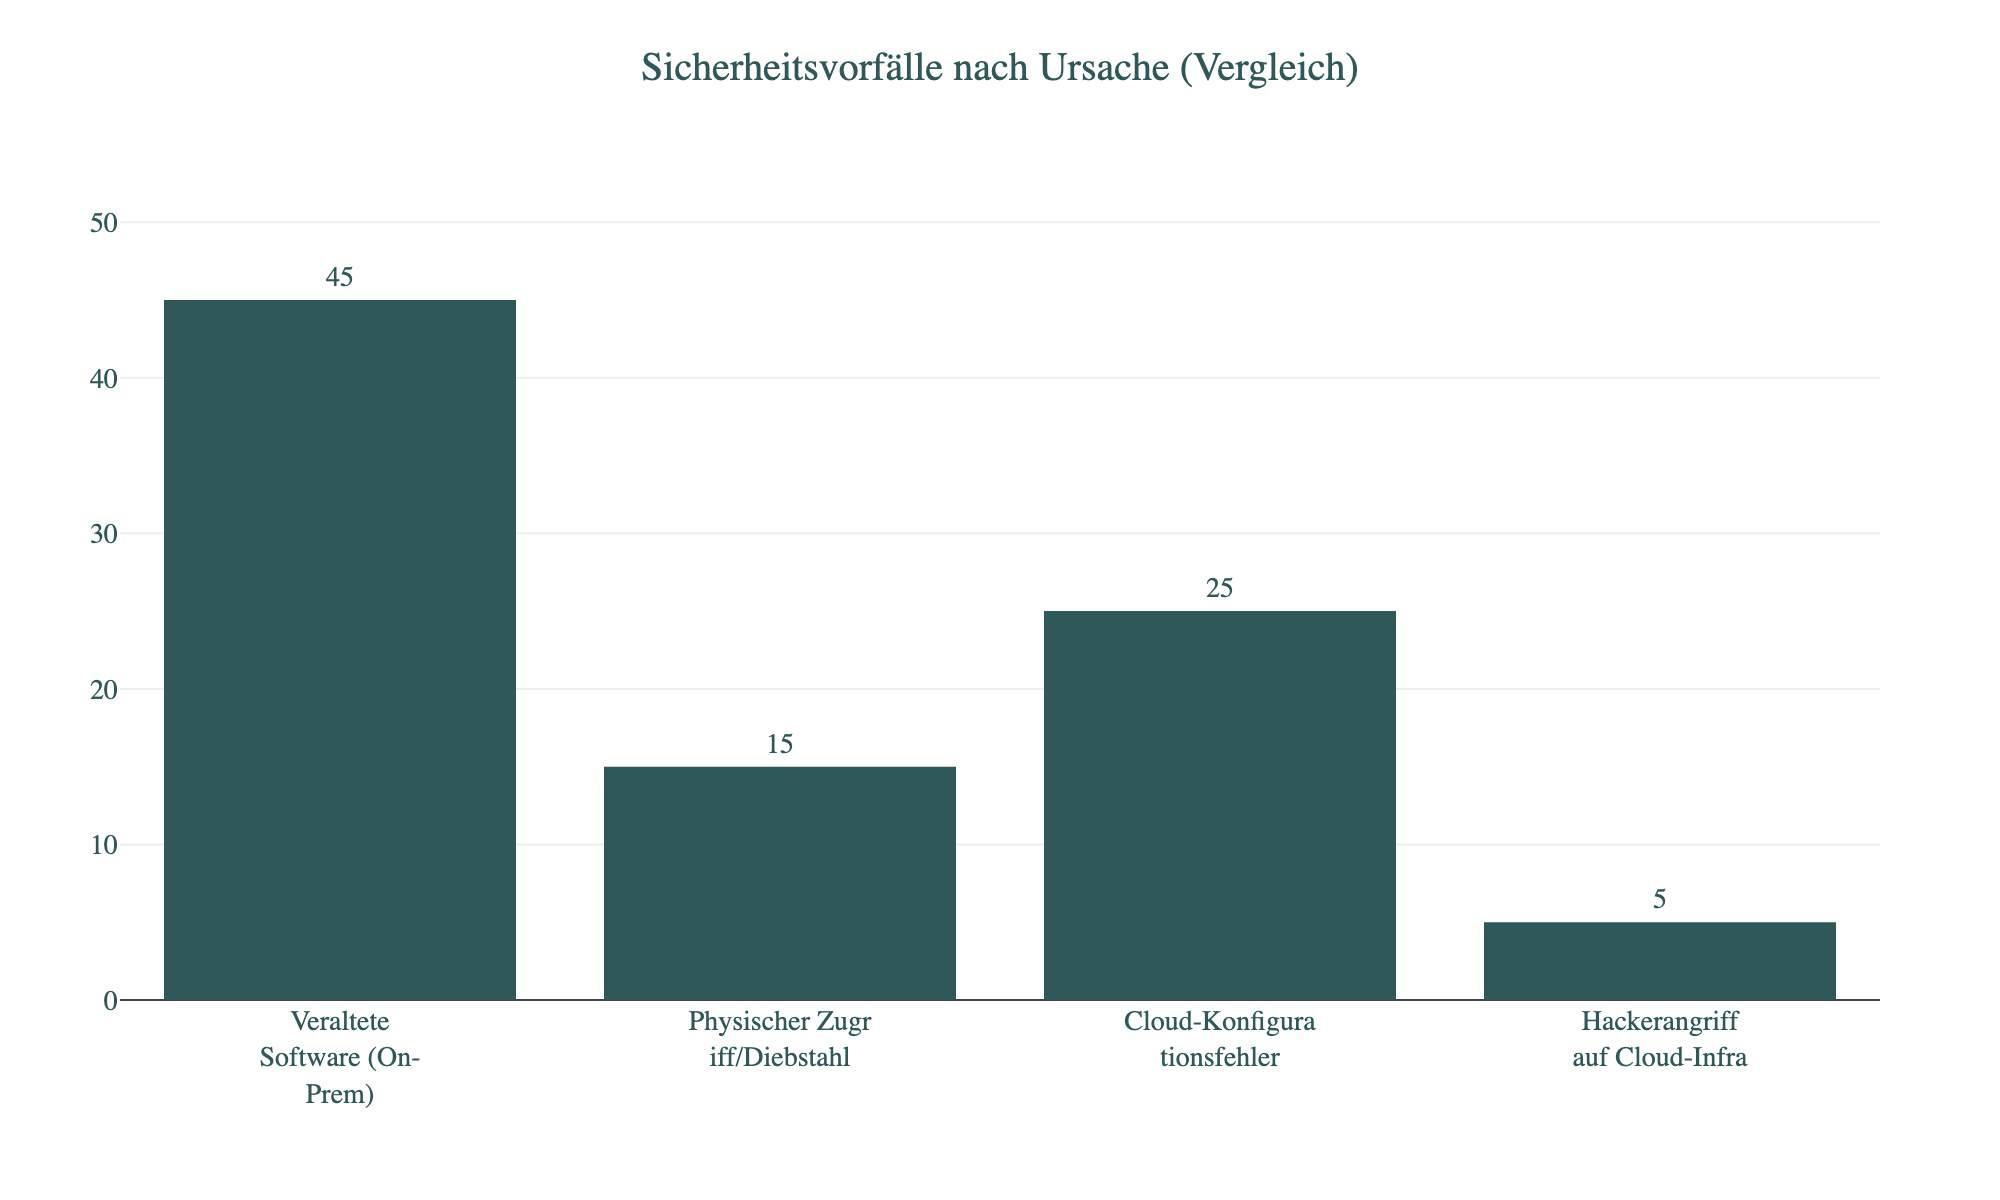
Zudem benötigt moderne KI Rechenleistung (GPUs), die man sich lokal kaum wirtschaftlich hinstellen kann. Wer KI-Modelle effizient nutzen oder sogar selbst „fine-tunen“ will, kommt an der Cloud kaum vorbei. Wichtig ist hierbei die Wahl des richtigen Standorts (EU-Hosting) und die saubere Verschlüsselung.
Spezialisierte Tools statt Allzweck-Lösungen
Der Hype um ChatGPT hat dazu geführt, dass viele Unternehmen versuchen, jedes Problem mit einem Chatbot zu lösen. Doch ein Large Language Model (LLM) ist kein Allheilmittel. Es ist ein Textgenerator, keine Rechenmaschine und keine Datenbank.
Für eine robuste technische Basis sollte man weg vom Gedanken der „eierlegenden Wollmilchsau“ und hin zu einer Architektur aus spezialisierten Agenten und Tools kommen.
- Vektordatenbanken (RAG): Man füttert die KI nicht mit allen Dokumenten auf einmal, sondern nutzt eine Vektordatenbank, um der KI nur die für die aktuelle Frage relevanten Textbausteine zu liefern (Retrieval Augmented Generation). Das erhöht die Präzision massiv und senkt die Halluzinationsrate.
- Autonome Agenten: Statt nur Text zu generieren, nutzen fortschrittliche Systeme wie OpenClaw spezifische Werkzeuge, um Aufgaben im Browser oder in Systemen autonom auszuführen.
- Code-Interpreter: Für Berechnungen und Datenanalysen sollte man die KI nicht „rechnen“ lassen (darin sind Sprachmodelle schlecht), sondern sie Code schreiben lassen, der dann in einer sicheren Umgebung ausgeführt wird.
Die Kunst der technischen Architektur liegt in der Orchestrierung: Ein LLM fungiert als „Gehirn“, das entscheidet, welches spezialisierte Tool für die Aufgabe gerade notwendig ist.
Datenqualität: Aufräumen ist Pflicht
Technik ist käuflich, Datenqualität muss man sich erarbeiten. Viele Unternehmen unterschätzen den Aufwand der Datenbereinigung („Data Cleansing“). Eine KI deckt gnadenlos jede Inkonsistenz auf.
- Duplikate: Ist „Müller GmbH“ derselbe Kunde wie „Mueller Gebrüder“? Für einen Menschen oft klar, für eine Datenbank zwei verschiedene Einträge.
- Vollständigkeit: Fehlen bei 30 % der Produkte die Gewichtsangaben? Dann kann die KI keine Versandkostenberechnung automatisieren.
- Aktualität: Sind die Daten von 2018 noch relevant für die Absatzprognose 2024?
Bevor man teure KI-Projekte startet, lohnt sich oft ein kleineres Projekt zur automatisierten Datenbereinigung. Hier kann KI übrigens auch schon helfen: Es gibt Modelle, die darauf trainiert sind, Dubletten zu erkennen oder fehlende Attribute logisch zu ergänzen.
Fazit zur Technik: Evolution statt Revolution
Man muss nicht die gesamte IT-Landschaft über Nacht abreißen. Der Weg zur KI-Reife ist eine Evolution. Man beginnt damit, kritische Daten aus Excel zu befreien, APIs zu öffnen und sich mit Cloud-Technologien anzufreunden.
Wer dabei Unterstützung braucht, sucht sich am besten Partner, die nicht nur Algorithmen verstehen, sondern auch die handfeste Softwareentwicklung dahinter. Genau hier setzt Skriptatelier an: Wir verbinden von unserem Standort in Diemelstadt-Wrexen aus moderne Webtechnologie mit intelligenter Automatisierung. Ob für Unternehmen hier in Nordhessen, in Paderborn oder bundesweit, wir bauen die technische Basis, damit KI nicht nur ein Spielzeug bleibt, sondern zum echten Wettbewerbsvorteil wird.
KI im B2B-Marketing und Vertrieb
Im B2B-Marketing und Vertrieb ist Zeit die härteste Währung. Während im B2C-Bereich oft Impulskäufe dominieren, kämpft man im Geschäftskundenumfeld mit langen Entscheidungszyklen, erklärungsbedürftigen Produkten und mehreren Entscheidern (Buying Center). Genau hier liegt der massive Hebel von Künstlicher Intelligenz: Sie entkoppelt die zeitintensive Vorarbeit von der wertvollen menschlichen Interaktion. Es geht nicht darum, den Vertriebler zu ersetzen, sondern ihn von der administrativen Last zu befreien, damit er sich auf den Abschluss konzentrieren kann.
Effiziente Texterstellung und Content-Skalierung
Das „leere Blatt Papier“ ist in modernen Marketingteams kein Problem mehr. Generative KI-Modelle wie GPT-4 oder Claude haben die Erstellung von Basisinhalten commoditized, also zur allgemein verfügbaren Ware gemacht. Doch die Gefahr liegt in der Beliebigkeit. Wer einfach nur „Schreibe einen Artikel über Industriepumpen“ in ein Tool tippt, erhält generischen Durchschnitt, der niemanden vom Hocker haut und im Google-Ranking untergeht.
Die wahre Kunst liegt in der Content-Veredelung und Skalierung.
Man nutzt die KI heute als Rohbau-Architekten. Sie liefert Struktur, erste Entwürfe und Variationen. Der Fachexperte übernimmt dann die Rolle des Bauleiters und Inneneinrichters. Er prüft Fakten, fügt exklusive Branchen-Insights hinzu und sorgt für die richtige Tonalität. Dieser Prozess, oft als „Human-in-the-Loop“ bezeichnet, steigert den Output massiv, ohne die Qualität zu opfern.
Der Prozess der Content-Skalierung
- Themen-Cluster statt Einzelartikel: Anstatt mühsam einzelne Blogpost-Ideen zu suchen, lässt man die KI auf Basis von Keyword-Daten ganze Themenwelten (Topic Clusters) entwerfen.
- Briefing-Automatisierung: Ein gutes Prompting-Framework erstellt für jeden Artikel ein detailliertes Briefing inkl. Gliederung, Zielgruppenansprache und SEO-Keywords.
- Variantenerstellung: Für Social Media (LinkedIn, Xing) muss der Content angepasst werden. Die KI formuliert aus einem Fachartikel binnen Sekunden drei verschiedene LinkedIn-Posts: einen provokanten, einen faktenbasierten und einen frageorientierten.
Besonders relevant ist dies für die SEO Optimierung. Suchmaschinen erkennen mittlerweile reine KI-Texte oft an ihrer flachen Informationsdichte. B2B-Content muss daher „Information Gain“ bieten, also Wissen, das so nicht schon zehnmal anderswo steht. Die KI hilft dabei, Lücken in den Inhalten der Wettbewerber zu identifizieren, indem man sie Top-Ranking-Seiten vergleichen lässt.
Hyper-Personalisierung in der Kaltakquise
Die Zeiten von „Sehr geehrte Damen und Herren“ oder schlecht gepflegten Platzhaltern in E-Mails sind vorbei. Im B2B-Vertrieb entscheidet oft der erste Eindruck über das Öffnen einer E-Mail. KI ermöglicht hier eine Hyper-Personalisierung im großen Maßstab.
Durch die Anbindung von KI-Tools an Datenbanken wie LinkedIn oder Firmenwebsites kann man für jeden Lead individuelle „Icebreaker“ generieren lassen. Das System analysiert: * Den letzten Post des Ansprechpartners auf LinkedIn. * Aktuelle Pressemitteilungen des Zielunternehmens. * Offene Stellenanzeigen (die oft auf akute Probleme hindeuten).
Daraus generiert die KI einen Einleitungssatz, der zeigt: „Ich habe mich mit dir beschäftigt“. Das erhöht die Antwortraten signifikant.
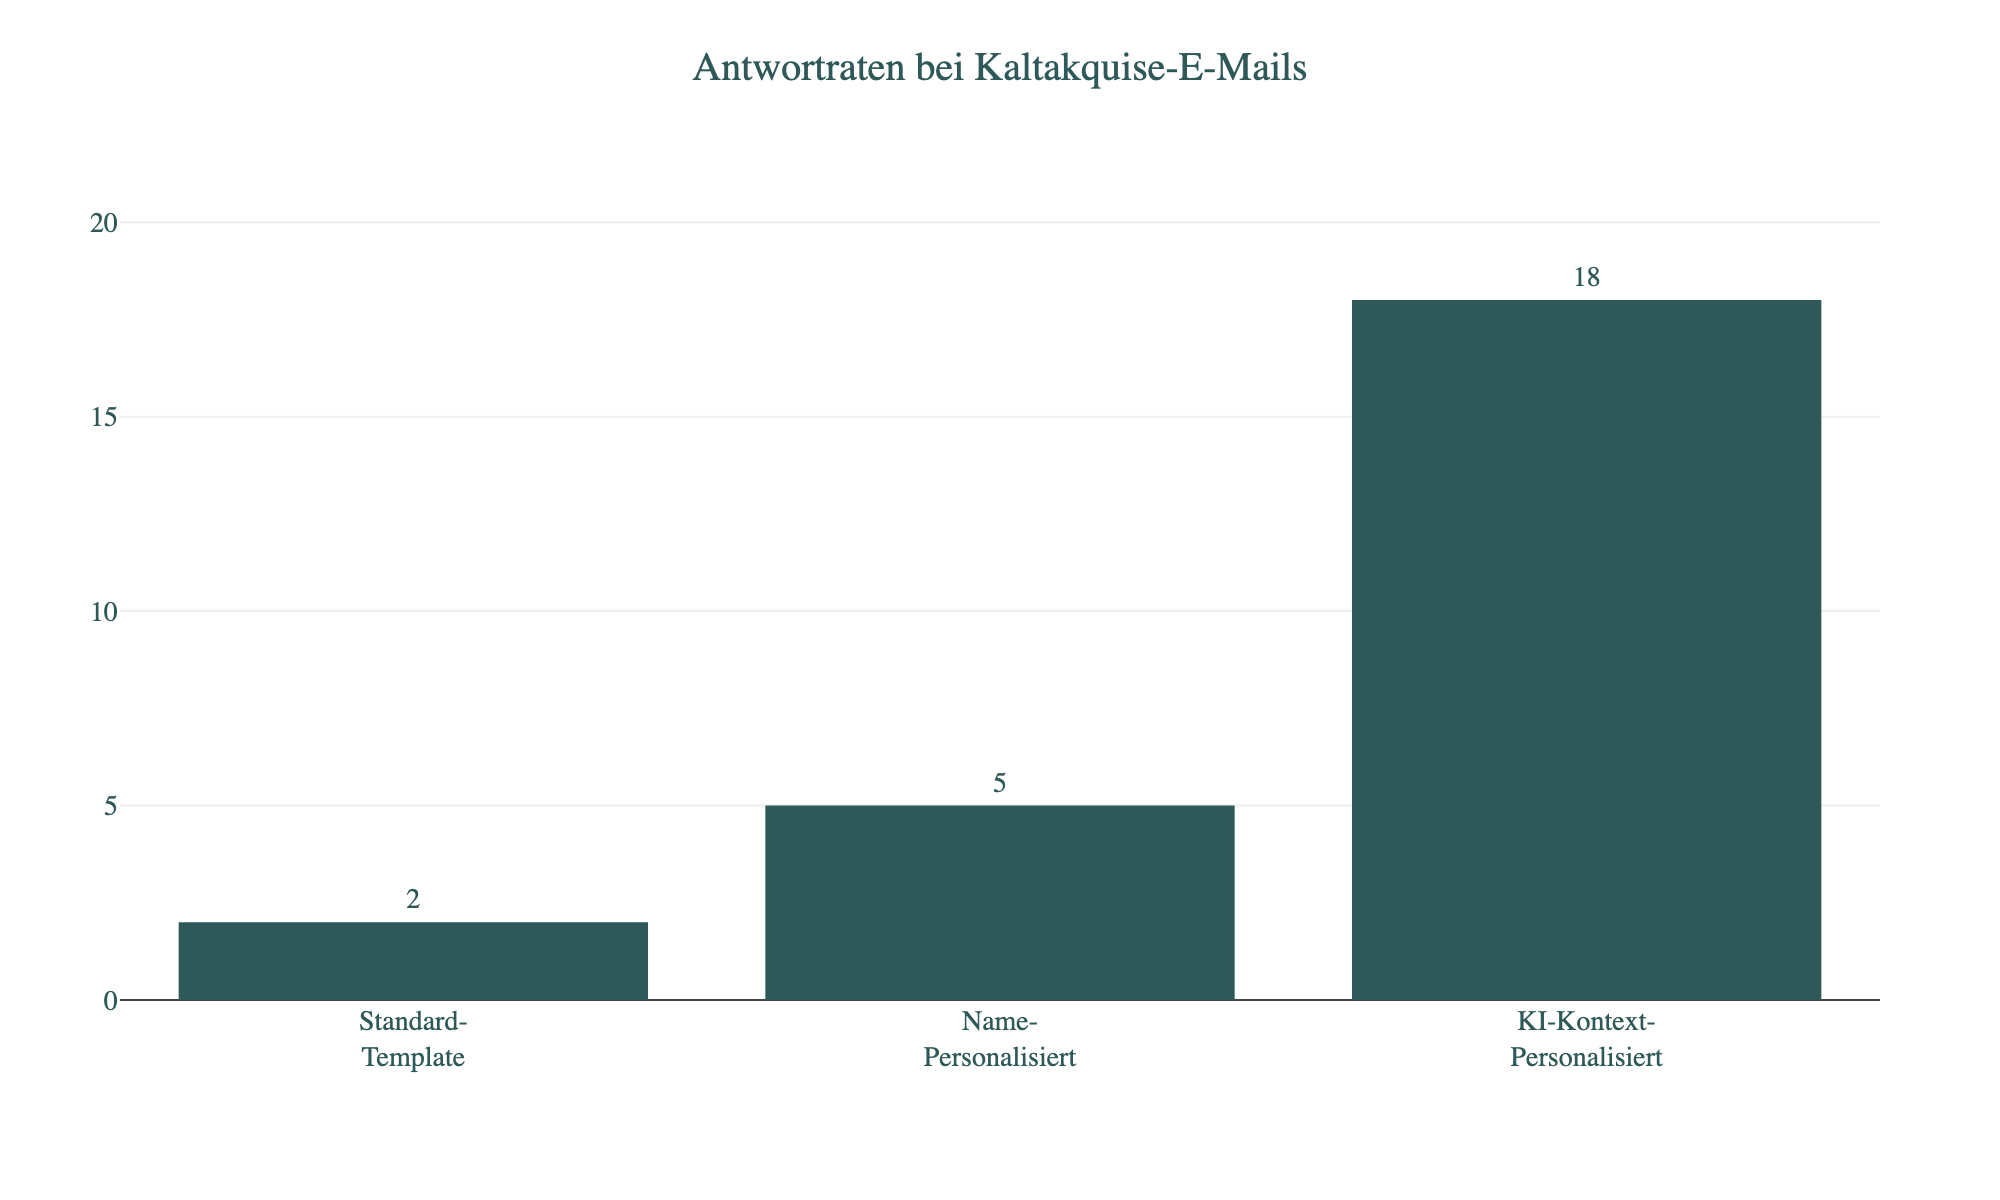
Es ist entscheidend, hierbei die Balance zu halten. Die Nachricht darf nicht wirken, als hätte ein Stalker sie geschrieben. Der Bezug muss immer professionell bleiben.
Automatisierung durch Voice-Bots und Chat-Assistenten
Während Text-KI bereits im Mainstream angekommen ist, steht die Audio-Revolution im B2B gerade erst am Anfang. Doch die Fortschritte sind gewaltig. Moderne Voice-Bots klingen kaum noch roboterhaft. Sie atmen, machen Pausen („äh“, „hmm“) und reagieren auf Unterbrechungen.
Für den Vertrieb und Kundenservice bedeutet das: 24/7 Erreichbarkeit ohne Personalaufbau.
Ein intelligenter Voice-Bot kann eingehende Anrufe qualifizieren, bevor sie den teuren menschlichen Vertriebler erreichen. * Szenario: Ein Interessent ruft an. Der Bot fragt nach Unternehmensgröße, Branche und konkretem Bedarf. * Filterung: Passt der Lead ins Raster, wird er durchgestellt oder erhält direkt einen Termin im Kalender des Sales-Managers. Passt er nicht (z.B. zu klein, falsche Branche), verweist der Bot höflich auf Self-Service-Ressourcen.
Vom Chatbot zum Agenten
Auf Websites sehen wir den Wandel vom Chatbot zum digitalen Kollegen. Frühere Bots basierten auf starren Entscheidungsbäumen (Wenn A, dann B). Wenn der Kunde vom Skript abwich, war der Bot hilflos.
KI-gestützte Chat-Assistenten nutzen Large Language Models (LLMs), um den Kontext zu verstehen. Sie können: 1. Technische Dokumentationen durchsuchen: Der Kunde fragt nach einem spezifischen Drehmoment für eine Maschine. Der Bot findet die Antwort im 500-seitigen PDF-Handbuch. 2. Produkte konfigurieren: Im Dialog führt der Bot den Kunden zur passenden Lösung. 3. Sprachbarrieren abbauen: Ein deutscher Mittelständler kann plötzlich Support auf Mandarin oder Spanisch anbieten, ohne Muttersprachler einzustellen.
Das schwarze Loch der Vertriebsdaten: Meeting-Analyse
Im B2B-Vertrieb passiert das Wichtigste immer noch im Gespräch, sei es via Zoom, Teams oder vor Ort. Das Problem: Diese Daten sind flüchtig. Was genau gesagt wurde, welche Einwände kamen und welche Stimmung herrschte, landet oft nur fragmentarisch in Notizbüchern oder dem Gedächtnis des Vertrieblers.
Hier setzt Conversation Intelligence an.
Tools zeichnen (mit Einwilligung aller Parteien) das Gespräch auf, transkribieren es und, das ist der entscheidende Teil, analysieren es. * Sentiment-Analyse: Wie war die Stimmung des Kunden bei der Preisnennung? Wurde er zögerlich oder blieb er positiv? * Talk-to-Listen-Ratio: Hat der Vertriebler den Kunden totgeredet oder aktiv zugehört? * Einwandbehandlung: Welche Fragen konnten nicht souverän beantwortet werden? Das liefert direkt Input für Produktschulungen.
Dies ermöglicht ein völlig neues Level an Coaching. Statt auf Bauchgefühl zu vertrauen, hat der Vertriebsleiter harte Daten darüber, was in Verkaufsgesprächen funktioniert und was nicht.
Automatische CRM-Pflege: Schluss mit Datenmüll
Niemand, der im Vertrieb arbeitet, mag CRM-Pflege. Das Eintragen von Telefonnotizen, das Aktualisieren von Deal-Stadien und das Nachtragen von Kontaktdaten frisst Zeit, die besser in Verkaufsgespräche investiert wäre. Die Folge: CRMs sind oft veraltet und unvollständig („Datenfriedhöfe“).
Die KI Integration in Unternehmen löst dieses Motivationsproblem durch Automatisierung.
Nach einem Meeting analysiert die KI das Transkript und extrahiert strukturierte Daten: 1. Identifikation: Wer hat gesprochen? Welche Rolle hat die Person? (Automatisches Anlegen oder Aktualisieren des Kontakts im CRM). 2. Next Steps: Was wurde vereinbart? (Automatisches Erstellen von Aufgaben im CRM: „Angebot senden bis Freitag“). 3. Deal-Wahrscheinlichkeit: Basierend auf den gesagten Worten (z.B. „Budget ist freigegeben“ vs. „Wir müssen mal schauen“) aktualisiert die KI das Scoring der Verkaufschance.
Technische Umsetzung via API
In der Praxis sieht das so aus: Ein Meeting-Bot (wie Fireflies oder tl;dv) sendet das Transkript an eine Schnittstelle (z.B. via Zapier oder Make). Dort verarbeitet ein LLM (wie GPT-4) den Text und gibt ein JSON-Objekt zurück, das exakt in die Felder des CRM-Systems (Salesforce, HubSpot, Pipedrive) passt.
Das Ergebnis ist eine saubere Datenbasis, ohne dass der Mitarbeiter auch nur ein Formularfeld manuell ausfüllen musste.
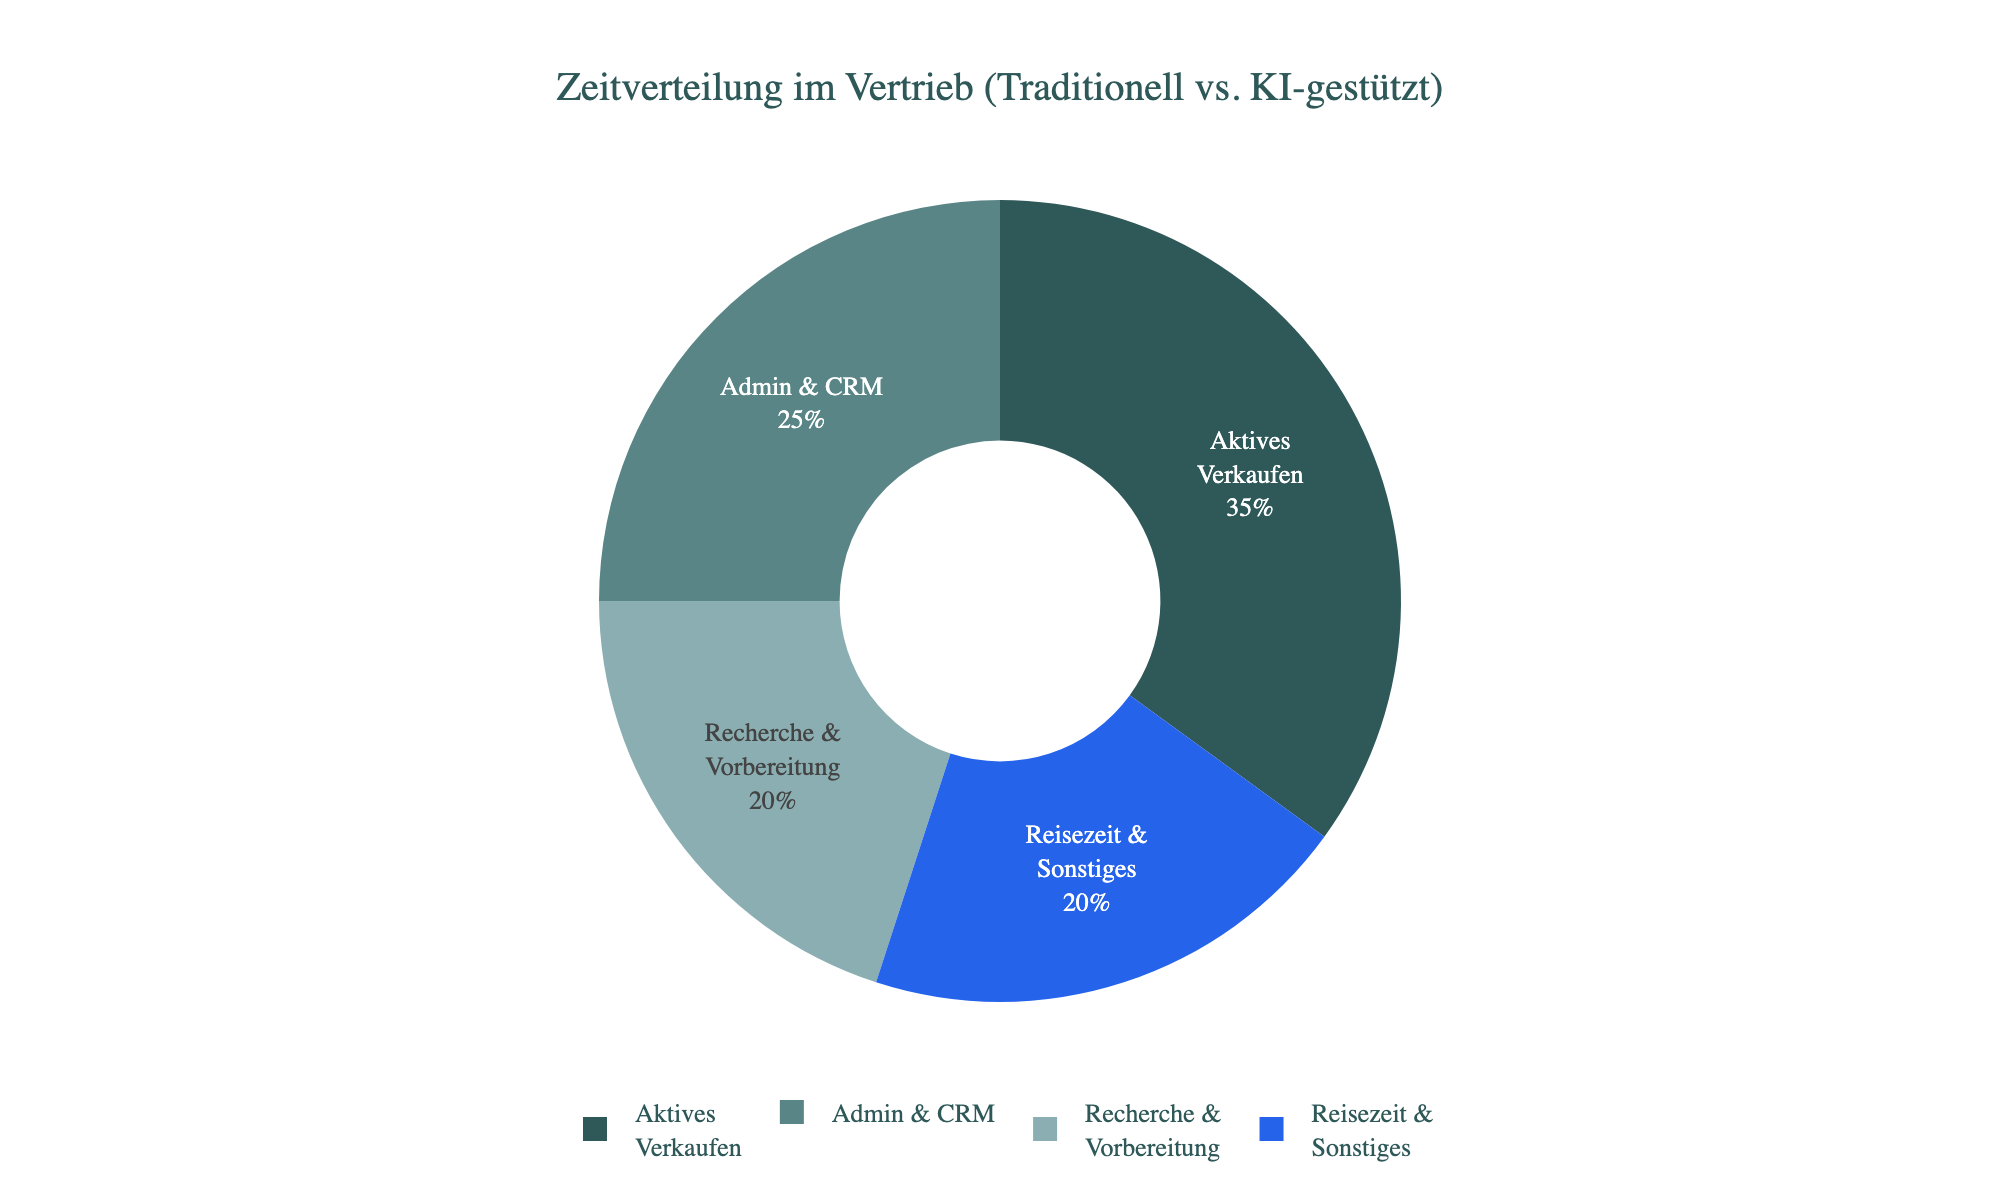
(Mit KI verschiebt sich der Anteil von Admin drastisch zugunsten von Aktivem Verkaufen).
Fazit zur Vertriebseffizienz
Die Einführung von KI im B2B-Vertrieb ist kein rein technisches Projekt, sondern eine Frage der Wettbewerbsfähigkeit. Wer seine hochbezahlten Experten weiterhin mit Dateneingabe und Standard-E-Mails beschäftigt, verbrennt Ressourcen. Die Kombination aus automatisierter Vorarbeit und menschlicher Empathie im Abschluss ist das Modell der Zukunft.
Für Unternehmen, die diesen Wandel pragmatisch angehen wollen, bietet Skriptatelier Unterstützung direkt aus der Praxis. Ob es um die Anbindung von CRM-Systemen oder die Entwicklung individueller Web-Lösungen geht, wir in Diemelstadt-Wrexen verstehen die Anforderungen des Mittelstands zwischen Kassel und Paderborn. Wir helfen dabei, die technischen PS auch wirklich auf die Straße zu bringen.
Produktivität im Büroalltag: Tools und Prompting
Wer KI-Tools im Büroalltag als reine Suchmaschinen-Alternative betrachtet, verschenkt etwa 80 Prozent des Potenzials. Produktivität durch Künstliche Intelligenz entsteht nicht durch das bloße Abfragen von Fakten, sondern durch die Delegierung kognitiver Routineaufgaben an einen digitalen Assistenten, der als „Sparringspartner“, Lektor, Programmierer oder Analyst fungiert. Der Schlüssel zum Erfolg liegt dabei weniger in der Wahl des einen „perfekten“ Tools, sondern in der Fähigkeit des Anwenders, Aufgaben so zu formulieren, dass die Maschine sie präzise ausführen kann.
Die Werkbank: Mehr als nur ChatGPT
Lange Zeit war ChatGPT das Synonym für generative KI. Inzwischen hat sich der Markt jedoch ausdifferenziert, und für professionelle Anwender lohnt sich der Blick über den Tellerrand. Man sollte die Tools nach ihren Stärken auswählen:
- ChatGPT (OpenAI): Der Allrounder. Besonders stark in der Breite des Wissens, der Bildgenerierung (DALL-E) und der Datenanalyse durch den Upload von Excel- oder PDF-Dateien.
- Claude (Anthropic): Oft die bessere Wahl für komplexe Textaufgaben, Nuancen in der Tonalität und Coding. Claude hat ein größeres „Kontext-Fenster“, kann also deutlich längere Dokumente (z.B. ganze Vertragsentwürfe oder technische Dokumentationen) in einem Rutsch verarbeiten, ohne den Faden zu verlieren. Wer sich für die Risiken und Fähigkeiten autonomer Agenten interessiert, findet bei Systemen wie Claude Opus und dessen Nachfolgern spannende Einblicke in die Leistungsspitzen der aktuellen Modelle.
- Perplexity: Eine Mischung aus Suchmaschine und KI. Anders als ChatGPT, das oft auf veraltetem Trainingswissen basiert, durchsucht Perplexity das Live-Internet und liefert Antworten mit Fußnoten und Quellenangaben. Ideal für Recherche-Arbeiten, bei denen die Faktenprüfung im Vordergrund steht.
- DeepL Write: Während der klassische DeepL-Übersetzer bekannt ist, wird „Write“ oft übersehen. Es hilft, deutsche oder englische Texte stilistisch zu glätten, ohne den Inhalt zu verfälschen, ein Segen für professionelle E-Mail-Korrespondenz.
- Microsoft Copilot / Google Gemini: Diese sind direkt in die Office-Umgebungen integriert. Der Vorteil liegt hier nicht zwingend in der Intelligenz des Modells, sondern in der nahtlosen Integration in Word, Excel oder Teams. Man kann „auf Knopfdruck“ Meeting-Transkripte in Aufgabenlisten verwandeln, ohne die App zu wechseln.
Prompt Engineering: Die Kunst der präzisen Anweisung
Ein Sprachmodell ist kein Gedankenleser. Es ist eine statistische Maschine, die basierend auf den eingegebenen Wörtern die wahrscheinlichste Fortsetzung berechnet. Das bedeutet: Schlechte Eingabe (Input) führt zwangsläufig zu schlechter Ausgabe (Output). Man nennt die Fähigkeit, diese Eingaben zu optimieren, „Prompt Engineering“.
Viele Anwender scheitern, weil sie mit der KI sprechen wie mit einer Suchmaschine („Marketingkonzept B2B“). Das Resultat ist generisches „Bla-Bla“. Um wirklich brauchbare Ergebnisse zu erzielen, hat sich eine strukturierte Formel bewährt, die man fast wie eine Checkliste abarbeiten kann:
- Persona (Rolle): Wer soll die KI sein? (z.B. „Du bist ein erfahrener Senior Marketing Manager für Maschinenbau.“)
- Kontext: Was ist der Hintergrund? (z.B. „Wir führen ein neues Produkt X ein, Zielgruppe sind Einkaufsleiter.“)
- Task (Aufgabe): Was genau soll getan werden? (z.B. „Erstelle 5 Ideen für LinkedIn-Posts.“)
- Constraints (Einschränkungen): Was soll vermieden werden? (z.B. „Keine Emojis, keine reißerischen Adjektive, maximale Länge 200 Wörter.“)
- Format: Wie soll das Ergebnis aussehen? (z.B. „Als Tabelle mit den Spalten: Titel, Inhalt, Bild-Idee.“)
Das „Chain-of-Thought“-Prinzip
Bei komplexen Aufgaben neigen KIs dazu, Schritte zu überspringen und direkt zur (oft falschen) Lösung zu springen. Man kann die Qualität massiv steigern, indem man die KI zwingt, ihren „Gedankengang“ offen zu legen.
Fügt man dem Prompt den Satz hinzu: „Denke Schritt für Schritt und erkläre deine Annahmen, bevor du die endgültige Antwort gibst“ (Think step-by-step), aktiviert man quasi den logischen Sektor des Modells. Besonders bei mathematischen Problemen, logischen Herleitungen oder der Analyse von Geschäftszahlen reduziert dies die Fehlerquote erheblich.
Few-Shot Prompting: Beispiele geben
Nichts hilft einem Menschen, und einer KI, mehr als ein gutes Beispiel. Statt nur zu beschreiben, was man will, gibt man Muster vor.
- Zero-Shot (Schlecht): „Schreibe eine Produktbeschreibung für diesen Schuh.“
- Few-Shot (Besser): „Ich gebe dir drei Beispiele für unseren Marken-Tonfall.
Beispiel 1: [Text A]
Beispiel 2: [Text B]
Beispiel 3: [Text C]
Aufgabe: Schreibe nun im exakt gleichen Stil eine Beschreibung für diesen neuen Schuh: [Daten].“
Diese Methode kalibriert das Modell auf den gewünschten Output, ohne dass man seitenlange Stilanweisungen schreiben muss. Dies ist besonders hilfreich, wenn man vom einfachen Chatbot zu digitalen Kollegen übergehen will, die konsistent in der Markenstimme kommunizieren.
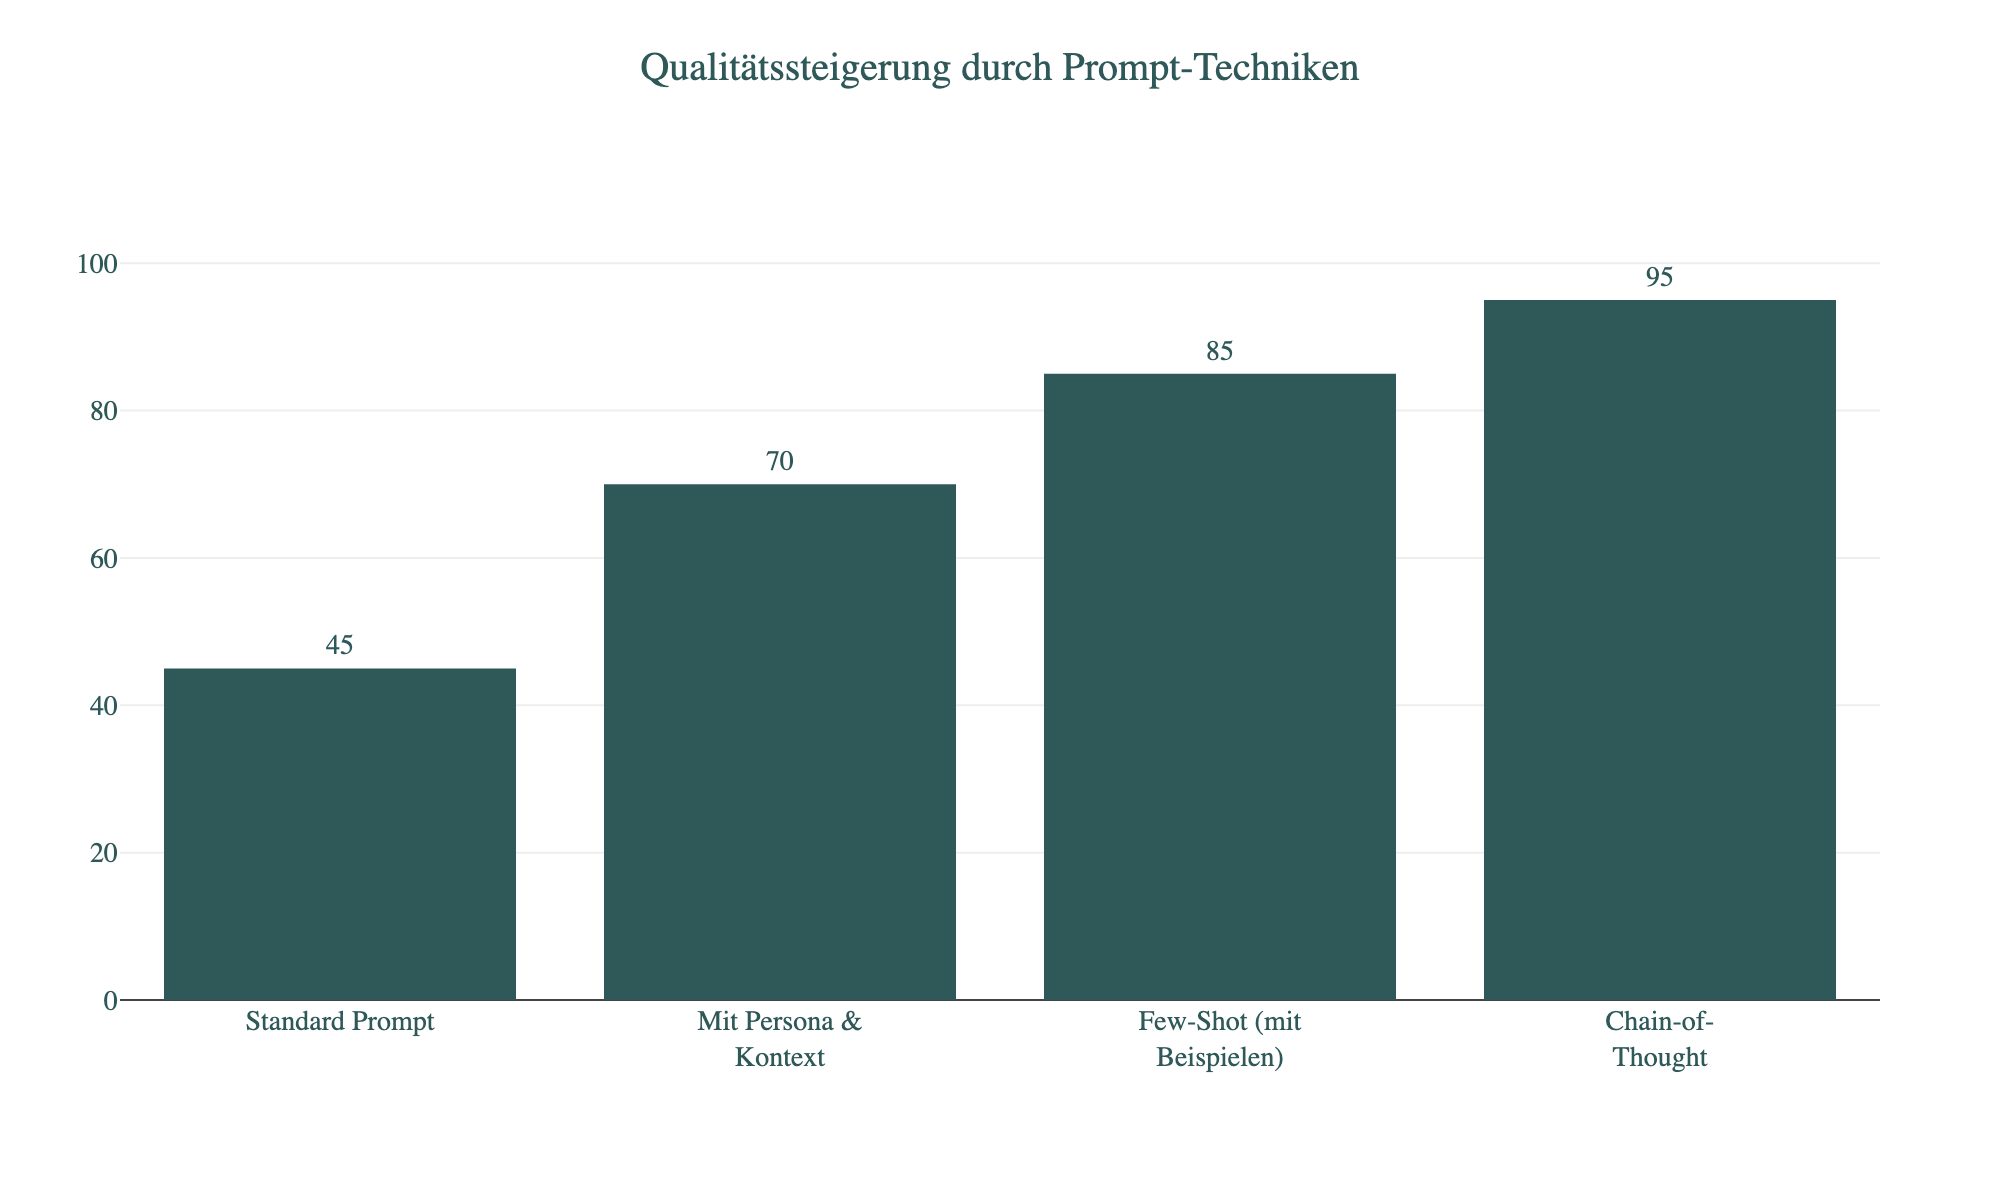
Umgang mit Halluzinationen: Vertrauen ist gut, Kontrolle ist Pflicht
Das größte Risiko im Büroalltag ist das blinde Vertrauen in die Eloquenz der Maschine. KI-Modelle „wissen“ nichts im menschlichen Sinne. Sie halluzinieren, wenn sie keine passenden Fakten im Trainingsdatensatz finden oder die logische Verknüpfung zu komplex ist. Das Tückische dabei: Eine halluzinierte Antwort klingt genauso überzeugend und selbstsicher wie eine korrekte Antwort.
Besonders anfällig sind: * Zitate und Quellen: KIs erfinden gerne Gerichtsurteile, Buchtitel oder Zitate, die plausibel klingen, aber nie existierten. * Biografische Daten: Bei weniger bekannten Personen vermischt die KI oft Lebensläufe. * Rechenaufgaben: Ohne spezielle Plugins (wie den Code Interpreter) sind Sprachmodelle erstaunlich schlecht in Mathematik, da sie Zahlen eher als Worte behandeln.
Strategien zur Fakten-Validierung
- Quellen-Pflicht: Man kann die KI anweisen: „Nutze nur Informationen aus dem angehängten Dokument. Wenn du die Antwort dort nicht findest, antworte mit ‚Ich weiß es nicht‘.“ Dies reduziert das freie Fabulieren drastisch.
- Der Vier-Augen-Check: Kritische Texte oder Fakten müssen immer (!) von einem Fachexperten geprüft werden. KI ist ein Entwurfs-Generator, kein finaler Entscheider.
- Spezialisierte Tools nutzen: Für Zahlen und Finanzen nutzt man Excel (ggf. mit Copilot), für Recherchen Tools mit Live-Webzugriff (Perplexity).
Vom Chat zur Automatisierung: Custom Instructions und Agenten
Wer jeden Tag bei Null anfängt und der KI immer wieder erklären muss, wer man ist („Ich arbeite in einer Agentur, duze mich, fasse dich kurz“), verliert Zeit. Moderne Tools bieten „Custom Instructions“ oder „System Prompts“. Hier hinterlegt man einmalig das Unternehmensprofil, die Tonalität und Standard-Regeln. Jede neue Konversation startet dann bereits mit diesem Vorwissen.
Einen Schritt weiter gehen sogenannte Agenten-Systeme. Während ein Chatbot passiv auf eine Eingabe wartet, können autonome Agenten Aufgabenketten abarbeiten. Ein Szenario wäre: „Überwache dieses Postfach auf Rechnungen, extrahiere die Daten, trage sie in das ERP-System ein und lege die PDF in Ordner X ab.“ Hier verschmilzt die KI-Integration in Unternehmen mit klassischer Prozessautomatisierung.
Es lohnt sich auch, einen Blick auf autonome Systeme wie OpenClaw zu werfen, um zu verstehen, wie KI künftig nicht nur textet, sondern aktiv Software bedient und Prozesse steuert.
Praktische Anwendungsfälle für den sofortigen Start
Um die Hürde der „weißen Seite“ zu überwinden, helfen konkrete Szenarien, die in fast jedem Büro anfallen:
- Der „Teufels Anwalt“: Man hat eine strategische Entscheidung getroffen und lässt die KI die Gegenposition einnehmen. „Ich plane X. Bitte analysiere diesen Plan kritisch, suche nach Schwachstellen und simuliere einen skeptischen Investor.“ Das schärft die eigene Argumentation.
- Excel-Formel-Generator: Statt komplizierte verschachtelte Formeln zu googeln, beschreibt man das Problem in natürlicher Sprache: „Ich habe in Spalte A ein Datum und in Spalte B einen Nettowert. Schreibe mir eine Excel-Formel, die mir die Summe aller Werte aus dem Monat März anzeigt.“
- Zusammenfassungen für die C-Level-Ebene: Lange Reports werden oft nicht gelesen. Die KI kann angewiesen werden: „Fasse diesen 20-seitigen Bericht in 5 Bulletpoints zusammen, fokussiert auf Risiken und Budget-Auswirkungen.“
- Unangenehme E-Mails: Mahnungen oder Absagen fallen oft schwer. Man kann der KI den Sachverhalt grob skizzieren („Kunde zahlt nicht, wir sind sauer, wollen ihn aber behalten“) und um einen höflichen, aber bestimmten Entwurf bitten.
Produktivität entsteht hier nicht durch die vollständige Ersetzung des Menschen, sondern durch die Beseitigung der Reibungsverluste bei Start- und Routineaufgaben. Wer diese Werkzeuge beherrscht, hat im Wettbewerb einen entscheidenden Geschwindigkeitsvorteil.
Kulturwandel: Das Team auf die Reise mitnehmen
Technologie ist der Motor, aber die Unternehmenskultur ist das Getriebe. Wenn hier Sand im Getriebe ist, nützt der stärkste KI-Motor nichts, das Fahrzeug bewegt sich nicht. Der häufigste Grund, warum KI-Transformationen nach der ersten Euphorie ins Stocken geraten, ist nicht technisches Versagen, sondern menschlicher Widerstand. Mitarbeiter fühlen sich überrollt, nicht abgeholt oder schlichtweg bedroht. Ein erfolgreicher Wandel beginnt daher nicht im Serverraum, sondern in der Kaffeeküche und im Konferenzraum.
Es reicht nicht, Lizenzen für ChatGPT oder Copilot zu kaufen und eine Rundmail zu schicken. Man muss ein Umfeld schaffen, in dem Neugier die Skepsis besiegt und in dem Fehler als Lernchance begriffen werden. Wer diesen kulturellen Aspekt vernachlässigt, riskiert, dass teure Tools ungenutzt bleiben oder, schlimmer noch, aktiv boykottiert werden.
Die Psychologie der Veränderung: Ängste ernst nehmen
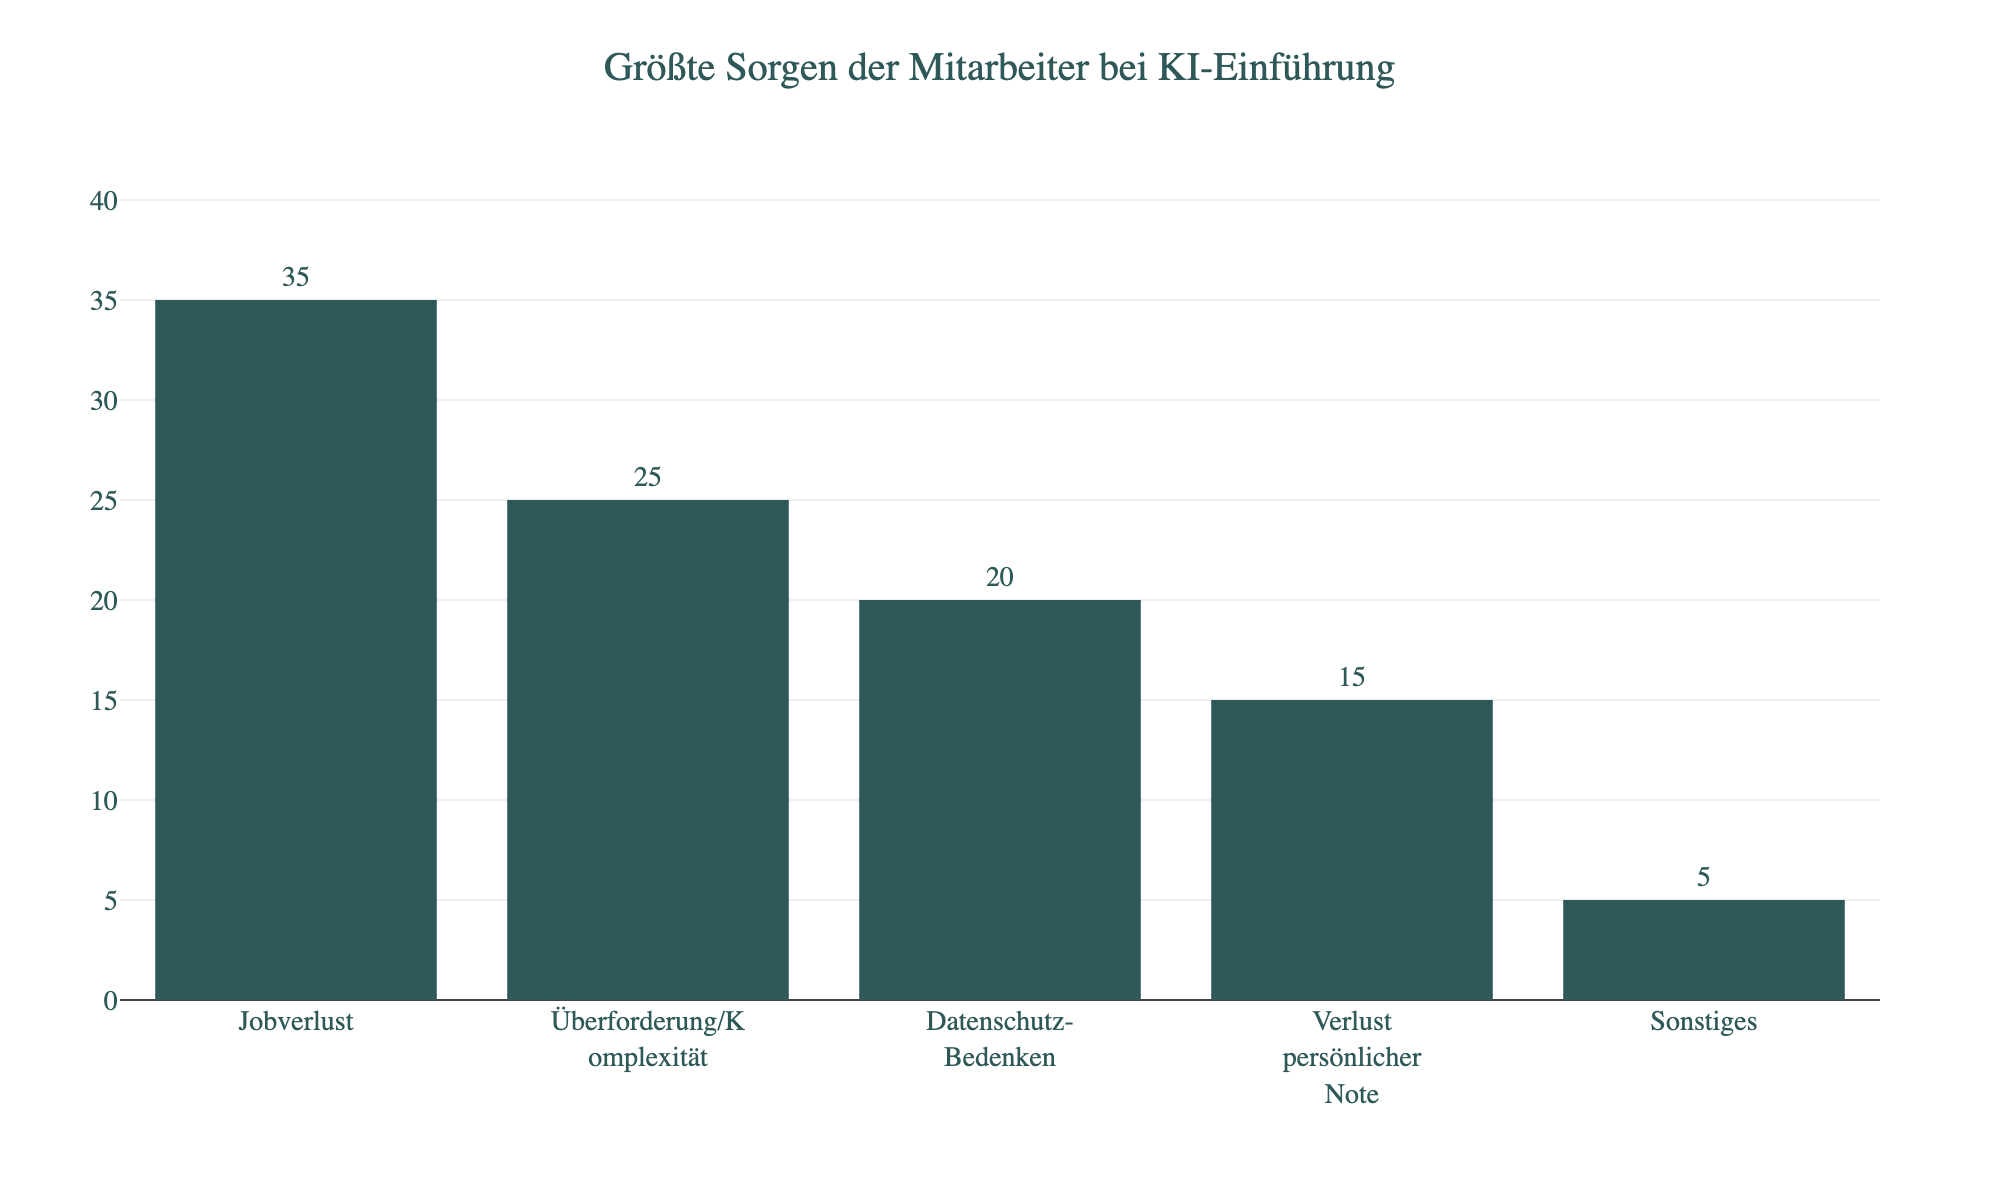
Wenn das Wort „Künstliche Intelligenz“ fällt, hören viele Angestellte nicht „Produktivitätssteigerung“, sondern „Wegrationalisierung“. Diese Sorge ist tief menschlich. In Deutschland, wo Arbeitsplatzsicherheit ein hohes Gut ist, wiegt die Angst vor dem Kontrollverlust besonders schwer. Man darf diese Bedenken nicht als Fortschrittsfeindlichkeit abtun.
Die Narrative in den Medien schwanken oft zwischen Utopie und Dystopie. Im Unternehmen braucht es hingegen einen realistischen Pragmatismus. Die Führungsebene muss klar kommunizieren: KI ist kein Ersatz für den Menschen, sondern ein Exoskelett für das Gehirn. So wie ein E-Bike einem Radfahrer hilft, den Berg schneller und mit weniger Schweiß zu erklimmen, hilft die KI dem Sachbearbeiter, komplexe Daten schneller zu verarbeiten. Der Mensch lenkt, die Maschine liefert die Kraft.
Eine transparente Kommunikation über die Ziele ist essenziell. Will man Personal abbauen? Wenn ja, wird man ohnehin auf Widerstand stoßen. Meistens geht es aber darum, dem Fachkräftemangel zu begegnen und bestehende Teams von monotoner Arbeit zu entlasten, damit sie sich auf wertschöpfende Tätigkeiten konzentrieren können. Diese Botschaft muss glaubwürdig und wiederholt gesendet werden.
Vom Tech-Projekt zum Business-Projekt: Die Rolle der Domain-Experten
Ein fataler Fehler ist die Annahme, KI sei alleinige Aufgabe der IT-Abteilung. IT-Spezialisten verstehen zwar den Code, die API-Schnittstellen und die Server-Infrastruktur, aber sie verstehen selten die feinen Nuancen eines Verkaufsgesprächs, die Tonalität im Kundenservice oder die komplexen Abwägungen in der Buchhaltung.
Wenn Entwickler im Alleingang KI-Lösungen für Fachabteilungen bauen, kommen oft Werkzeuge heraus, die technisch brillant, aber praktisch unbrauchbar sind. Hier kommen die Domain-Experten ins Spiel. Das sind die langjährigen Mitarbeiter, die das Geschäft in- und auswendig kennen. Sie wissen, welche Fragen Kunden wirklich stellen und wo im Prozess der Schuh drückt.
Man muss diese Fachexperten zu „Product Ownern“ der KI-Lösungen machen. Nicht der Programmierer sollte entscheiden, wie der Text-Generator für E-Mails klingt, sondern der erfahrene Vertriebler. Dieser Ansatz hat zwei massive Vorteile: 1. Qualität: Die Ergebnisse der KI werden fachlich präzise und praxisnah. 2. Akzeptanz: Wenn die Lösung „aus der Mitte des Teams“ kommt und nicht „von oben herab“ verordnet wird, ist die Bereitschaft zur Nutzung deutlich höher. Dies ist ein Kernaspekt erfolgreicher KI Integration in Unternehmen.
Es entsteht eine neue Rolle: der „AI Translator“. Das sind Mitarbeiter, die sowohl die Sprache der Fachabteilung als auch die Grundzüge der Technologie verstehen und zwischen beiden Welten vermitteln.
Enablement: Schulung ist mehr als ein Workshop
Die Einführung von KI-Tools erfordert neue Kompetenzen. „Prompt Engineering“, also die Fähigkeit, der Maschine präzise Anweisungen zu geben, wird zur Schlüsselqualifikation des 21. Jahrhunderts. Doch wie bringt man das einer Belegschaft bei, die in Alter und technischer Affinität oft sehr heterogen ist?
Ein einmaliger Workshop reicht nicht aus. Lernen ist ein Prozess. Man sollte ein Stufenmodell für die Ausbildung etablieren:
- Basics für alle: Jeder im Unternehmen muss verstehen, was Generative KI ist, wo die Grenzen liegen (Halluzinationen!) und welche Datenschutzregeln gelten.
- Power-User-Training: Für Mitarbeiter, die täglich mit Texten, Code oder Analysen arbeiten, braucht es vertiefende Schulungen. Wie baue ich komplexe Prompts? Wie verkette ich Arbeitsschritte? Hier lohnt sich der Blick auf Agenten-Workflows, die über einfache Chat-Interaktionen hinausgehen.
- Lern-Tandems: Man setzt einen digital-affinen Junior mit einem erfahrenen Senior zusammen. Der Junior erklärt die KI-Tools, der Senior erklärt die fachlichen Hintergründe, die die KI berücksichtigen muss. Beide profitieren.
Compliance und Schatten-IT: Vertrauen durch klare Leitplanken
Nichts lähmt die Kultur mehr als Unsicherheit. „Darf ich das überhaupt nutzen?“ ist eine Frage, die Innovation im Keim erstickt. Wenn es keine offiziellen Regeln gibt, entsteht Schatten-IT. Mitarbeiter nutzen dann ihre privaten ChatGPT-Accounts auf dem Handy, kopieren Firmendaten hinein und umgehen alle Sicherheitsmaßnahmen, nur um ihre Arbeit schneller zu erledigen.
Um das zu verhindern, muss die Führungsebene proaktiv klare Leitplanken setzen. Ein generelles Verbot ist meist kontraproduktiv und wird ohnehin umgangen. Stattdessen empfiehlt sich eine „Ampel-Regelung“:
- Grün: Unkritische Daten (Marketingtexte, allgemeine Recherchen, Code-Snippets ohne Business-Logik). Hier dürfen freigegebene Tools genutzt werden.
- Gelb: Interne Daten ohne Personenbezug. Nutzung nur mit Enterprise-Tools, die vertraglich zusichern, Daten nicht zum Training zu verwenden.
- Rot: Personenbezogene Daten (HR, Kundendaten) oder strikte Geschäftsgeheimnisse. Hier ist der Einsatz öffentlicher KI-Modelle tabu, es sei denn, man nutzt speziell gesicherte, oft lokal gehostete Lösungen oder autonome Agenten wie OpenClaw, bei denen die Datenhoheit gewahrt bleibt.
Besonders im Hinblick auf den kommenden EU AI Act 2026 ist es wichtig, dass Compliance nicht als Bremser, sondern als Ermöglicher verstanden wird. Wer die Regeln kennt, kann sich innerhalb dieser Grenzen frei und kreativ bewegen.
Führungskräfte als Vorbilder
Wasser predigen und Wein trinken funktioniert hier nicht. Wenn der Geschäftsführer seine E-Mails weiterhin diktiert und abtippen lässt, während er vom Team „digitale Transformation“ fordert, macht er sich unglaubwürdig. Führungskräfte müssen die ersten sein, die sich auf das neue Terrain wagen.
Es hat eine enorme Signalwirkung, wenn der Abteilungsleiter in einem Meeting zugibt: „Ich habe mir bei der Vorbereitung dieser Strategie von der KI helfen lassen, aber ich musste drei Punkte korrigieren.“ Das zeigt: 1. Die Nutzung ist gewünscht. 2. Die KI ist nicht perfekt. 3. Der Mensch hat die letzte Entscheidungskompetenz.
Ein offener Umgang mit den Schwächen der Technologie („Das hat heute gar nicht funktioniert“) ist genauso wichtig wie das Feiern von Erfolgen („Das hat mir zwei Stunden Arbeit gespart“). Dies schafft eine Kultur der psychologischen Sicherheit, in der Experimente erlaubt sind.
Von der Einzelnutzung zur kollaborativen Intelligenz
Der Kulturwandel ist erst dann vollzogen, wenn KI nicht mehr als isoliertes Werkzeug eines Einzelnen, sondern als integraler Bestandteil von Teamprozessen gesehen wird. Zukünftig werden wir nicht nur mit Chatbots reden, sondern ganze individuelle Software-Lösungen nutzen, in denen KI-Agenten im Hintergrund Daten aufbereiten, bevor ein Mensch überhaupt den Prozess beginnt.
Man muss weg vom Denken in „Tasks“ (Aufgaben) hin zum Denken in „Workflows“ (Abläufen). Wenn das Team begreift, dass die KI den langweiligen Teil der Arbeit übernimmt, das Sichten, Sortieren und Zusammenfassen, und ihnen den kreativen, strategischen Teil überlässt, wandelt sich die anfängliche Skepsis oft in Begeisterung.
Abschließend lässt sich sagen: Der Erfolg von KI im Mittelstand entscheidet sich nicht an der Anzahl der GPUs im Rechenzentrum, sondern an der Anzahl der Mitarbeiter, die morgens ins Büro kommen und denken: „Mal sehen, was ich heute mit meinem digitalen Kollegen alles schaffen kann.“
Fazit
Die erfolgreiche Einführung von Künstlicher Intelligenz in Unternehmen scheitert selten an der Technologie selbst, sondern meist an fehlenden Strategien und mangelnder interner Kommunikation. Wer KI nur als isoliertes IT-Experiment betrachtet und die Erfolge nicht aktiv im Unternehmen sichtbar macht, lässt wertvolles Potenzial liegen. Es ist entscheidend, Mitarbeiter frühzeitig einzubinden, Ängste durch Aufklärung abzubauen und den Fokus von unzähligen Testprojekten auf produktive Anwendungsfälle zu verlagern, die messbare wirtschaftliche Ergebnisse liefern.
Gleichzeitig darf der Datenschutz nicht als dauerhafte Bremse dienen. Mit professionellen Enterprise-Lösungen, einer sauberen Datenbasis und der Beachtung der „Human-in-the-Loop“-Prinzipien lässt sich KI auch in Europa rechtskonform einsetzen. Anstatt auf die perfekte Allzweck-Lösung zu warten, empfiehlt es sich, pragmatisch mit spezialisierten Tools zu starten und Prozesse Schritt für Schritt zu automatisieren. Der Wettbewerbsvorteil liegt heute bei denen, die praktische Umsetzung und notwendige Regulierung vereinen, statt vor der Komplexität zu erstarren.
Quellen
Verwendete Video-Quelle: https://www.youtube.com/watch?v=R3b0Vvh5A0A&pp=ygUba2kgaW0gdW50ZXJuZWhtZW4gZWluc2V0emVu
Weiterführende Recherchen und Fachinformationen:
Bundesamt für Sicherheit in der Informationstechnik (BSI): Chancen und Risiken großer KI-Sprachmodelle https://www.bsi.bund.de/DE/Themen/Unternehmen-und-Organisationen/Informationen-und-Empfehlungen/Kuenstliche-Intelligenz/Grosse-KI-Sprachmodelle/grosse-ki-sprachmodelle_node.html Kontext: Das BSI analysiert Sicherheitsrisiken wie Prompt Injection und gibt Handlungsempfehlungen für den sicheren Einsatz von LLMs in Unternehmen.
Datenschutzkonferenz (DSK): Orientierungshilfe Künstliche Intelligenz und Datenschutz https://www.datenschutzkonferenz-online.de/ * Kontext: Die DSK bietet ein offizielles Papier an, das Kriterien für die datenschutzkonforme Auswahl und Nutzung von KI-Anwendungen gemäß DSGVO definiert.
Bitkom e.V.: Leitfaden Generative KI im Unternehmen https://www.bitkom.org/Bitkom/Publikationen/Leitfaden-Generative-KI-im-Unternehmen * Kontext: Ein praxisnaher Leitfaden des Digitalverbands, der rechtliche Fragen (Urheberrecht, AI Act) und technische Implementierungsschritte beleuchtet.
Europäische Kommission: Der AI Act (Gesetz über künstliche Intelligenz) https://digital-strategy.ec.europa.eu/de/policies/regulatory-framework-ai * Kontext: Offizielle Informationen zum ersten umfassenden Rechtsrahmen für KI weltweit, inklusive der Risikoklassifizierung für Unternehmensanwendungen.